Yeni sürüm çıkarken birkaç saniyelik hata görmeyen ekip azdır. Kullanıcı bir hata sayfası görür, bir alarm çalar, biri de "deploy'dandır, geçti" der. Kubernetes'te çalışan bir sürümü değiştirmenin birkaç yolu var ve varsayılan ayarlar sıfır kesintiyi garanti etmiyor. Bu yazıda önce zero-downtime deployment'ın ne olduğuna, her stratejinin neyi çözüp neye mal olduğuna bakıyorum. Sonra lab'a geçiyorum: bir uygulamaya saniyede 40 istek gönderirken onu altı farklı yolla güncelledim ve düşen her isteği saydım. Her şey beklediğim gibi gitmedi; o kısımlar gerçek çıktılarıyla en sonda.
Zero-downtime deployment nedir?
Zero-downtime deployment, uygulamanın çalışan sürümünü yenisiyle değiştirirken hiçbir isteğin cevapsız kalmaması demek. Sürüm çıkarken hata sayfası, zaman aşımı, "lütfen tekrar deneyin" yok.
Kubernetes'te aynı pod'lardan oluşan grubu bir Deployment yönetiyor. Eski pod'ların yenileriyle nasıl değişeceğine de Deployment'taki strategy alanı karar veriyor:
- Recreate: önce bütün eski pod'lar durur, sonra yeniler başlar.
- RollingUpdate (varsayılan): pod'lar birkaç birkaç değişir, böylece her an çalışan pod olur.
İki strateji daha var ama bunlar bir alan değil, Deployment ve Service ile kuruluyor:
- Blue/green: yeni sürüm eskisinin yanında eksiksiz ayağa kalkar, trafik tek seferde ona çevrilir.
- Canary: trafiğin küçük bir kısmı önce yeni sürüme gider, sorun yoksa pay büyütülür.
Bunlardan hangisinin gerçekten kesintisiz olacağı tek bir şeye bağlı: Kubernetes yeni pod'un trafiği karşılamaya gerçekten hazır olduğunu bilmeli. Bunu söyleyen de readiness probe.
Neyi çözüyor?
Kullanıcının fark ettiği sürümler. Her deploy birkaç saniye hataya yol açıyorsa ekip deploy etmekten çekinmeye başlıyor. Sürümler geceye, "sürüm pencerelerine" kayıyor. Küçük değişiklikler birikiyor ve büyük, riskli sürümlere dönüşüyor.
"Çalışıyor" demek "hazır" demek değil. Container çalışmaya başladıktan sonra içindeki uygulamanın portu dinlemesi saniyeler sürebilir. Config yükler, cache'i ısıtır, veritabanına bağlanır. Readiness probe yoksa Kubernetes bunu beklemeden trafiği gönderiyor.
Sürüm kadar uzun süren geri dönüşler. Yeni sürüm bozuksa eskisine dönmek saniyeler almalı, bir rollout daha değil.
Her strateji ne kazandırıyor?
| Strateji | Pratikte ne demek | Lab'da (2.400 istek) |
|---|---|---|
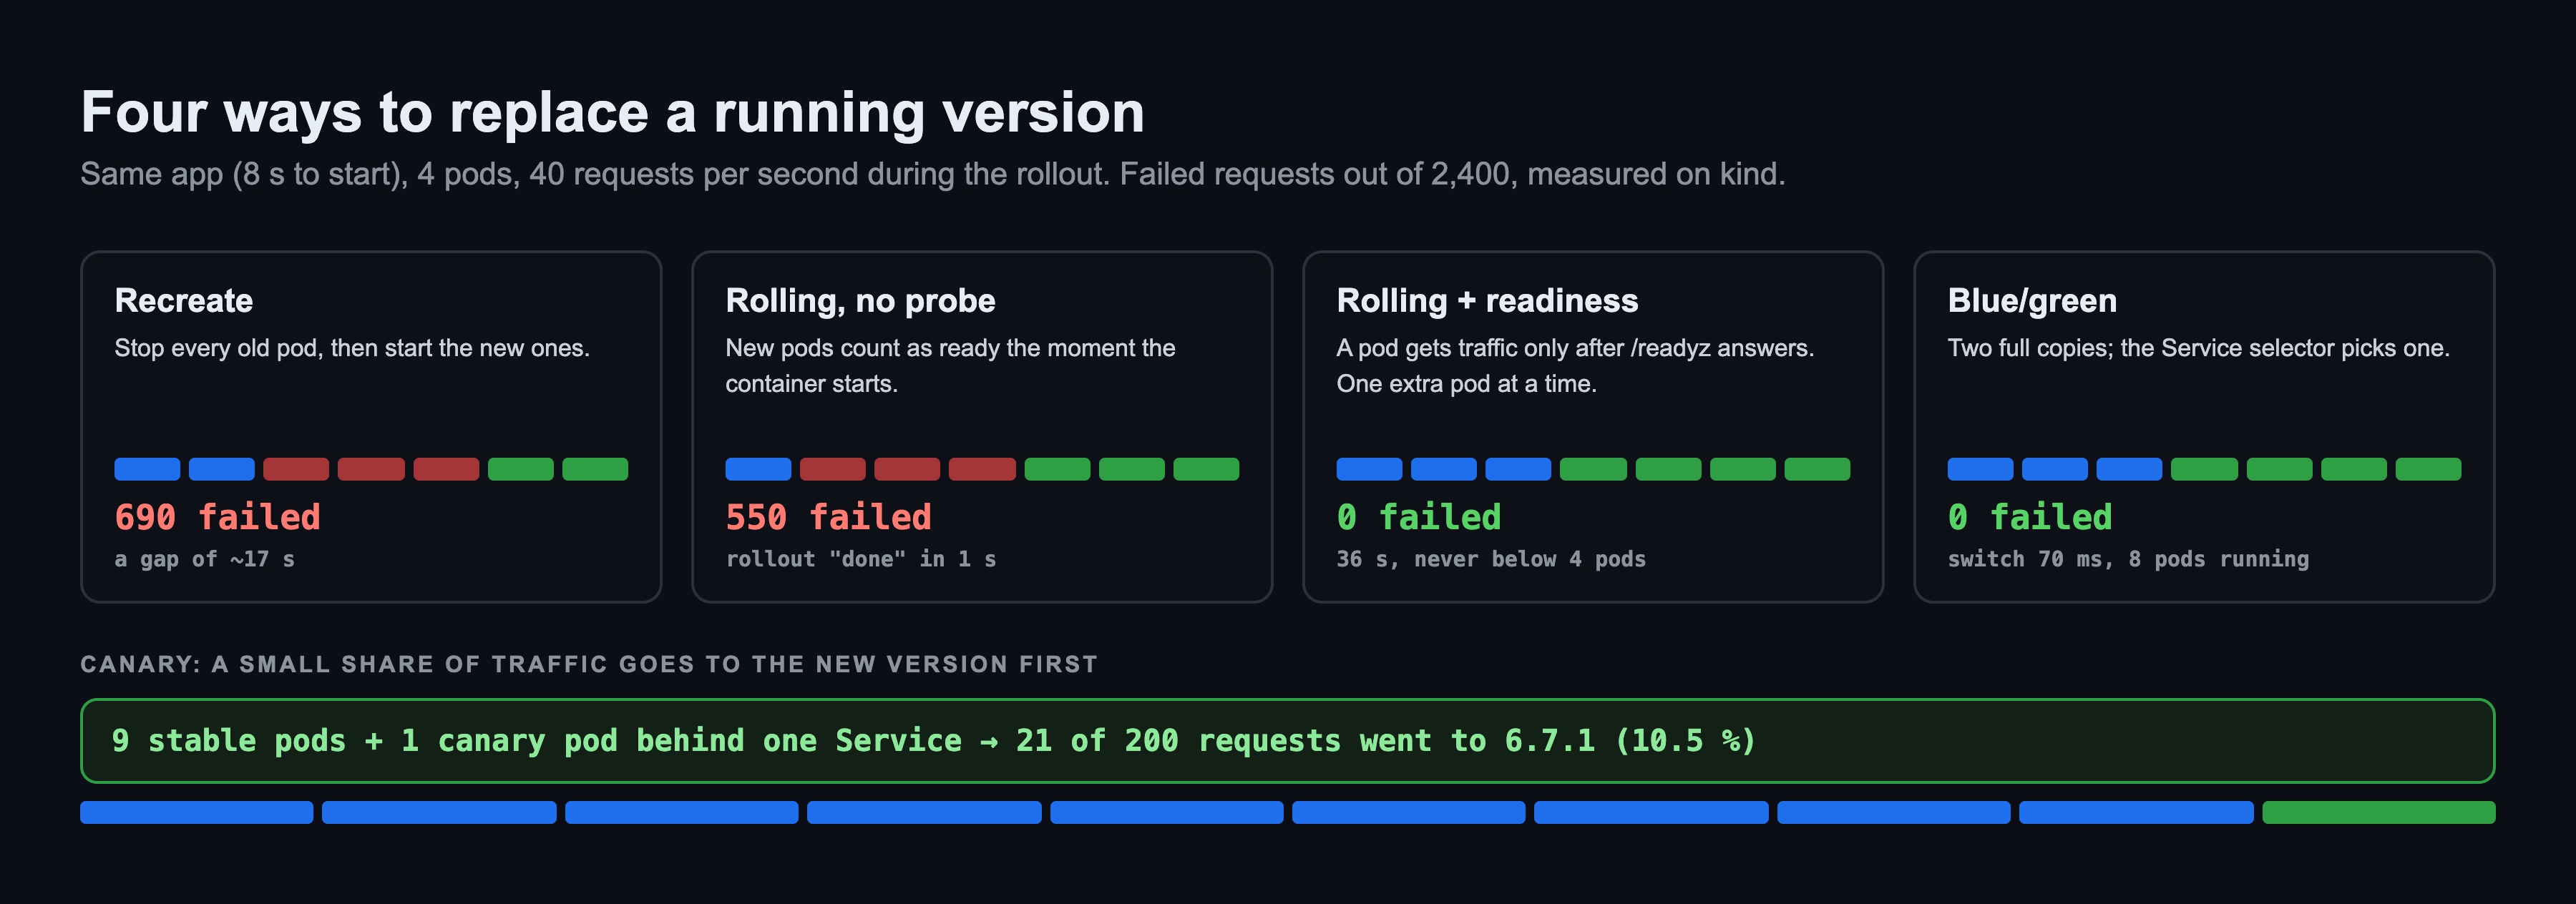
| Recreate | Basit, iki sürüm hiç aynı anda çalışmıyor; ama arada hiçbir şeyin çalışmadığı bir boşluk var | 690 hata, rollout 32 sn |
| Readiness probe'suz RollingUpdate | Hızlı görünüyor; yeni pod'lar uygulama portu dinlemeden trafik alıyor | 550 hata, rollout 1 sn'de "bitti" |
| RollingUpdate + readiness probe | Trafik sadece hazır pod'lara gidiyor; maxUnavailable: 0 kapasiteyi hiç düşürmüyor |
0 hata, rollout 36 sn |
| Blue/green | Geçiş de geri dönüş de anında; geçiş sırasında iki kat pod | 0 hata, geçiş 70 ms, geri dönüş 94 ms |
| Canary | Yeni sürüm gerçek trafikle, önce küçük bir payla deneniyor | 200 isteğin 21'i yeni sürümde (%10,5) |
Kubernetes'in kendi araçlarıyla neyin olmadığını da bilmekte fayda var:
| İhtiyaç | Düz Kubernetes |
|---|---|
| Tek komutla blue/green | Yok. İki Deployment çalıştırıp Service selector'ını kendiniz değiştiriyorsunuz (ya da Argo Rollouts / Flagger kullanıyorsunuz). |
| %1 ya da %5'lik canary | Sadece pod sayısıyla olmuyor. 9 + 1 pod yaklaşık %10 ediyor. Tam ağırlık için Gateway API ya da service mesh gerekiyor. |
| Hata görünce kendiliğinden geri dönmek | Yok. Deployment siz söylemeden geri dönmüyor. Bunu progressive delivery araçları ekliyor. |
| Veritabanı migration'ları | Kubernetes karışmıyor. Rolling update sırasında iki sürüm aynı anda çalıştığı için şemanın ikisiyle de uyumlu olması gerekiyor. |
Nasıl çalışıyor?
- Service trafiği sadece hazır pod'lara gönderiyor. Service'in arkasındaki her pod ya hazır listesinde ya da değil. Readiness probe'u olmayan pod, container'ı başlar başlamaz hazır sayılıyor.
maxSurgevemaxUnavailablerolling update'in temposunu ayarlıyor.maxSurge: 1vemaxUnavailable: 0ile Kubernetes önce bir pod fazla açıyor, o pod hazır olunca eski pod'lardan birini kapatıyor.- Blue/green de canary de label ile yürüyor. Service pod'ları label'a göre seçiyor. Selector'ı değiştirirseniz trafik taşınıyor; iki Deployment'ı aynı label'ın altına koyarsanız trafik pod sayısına göre bölünüyor.
Lab: ne kurdum?
Her şey MacBook'ta kind üzerinde çalışıyor (Colima, 4 CPU / 8 GB). Kubernetes 1.37, bir control plane ve iki worker, varsayılan network eklentisi ve kube-proxy. Uygulama olarak podinfo kullandım, tek bir farkla: portu dinlemeye başlamadan önce 8 saniye bekliyor. Config okuyan, veritabanına bağlanan gerçek bir uygulama gibi. Dört pod 6.7.0 sürümünde, hepsini 6.7.1'e geçiriyorum. Her rollout boyunca cluster'ın içindeki fortio, Service üzerinden 60 saniye boyunca saniyede 40 istek atıyor; yani her koşuda 2.400 istek. Her senaryo tek bir make komutu, bütün lab yaklaşık 10 dakika sürdü.
Adım 1: Recreate
Recreate dört eski pod'u kapatıyor, tamamen gitmelerini bekliyor, sonra dört yenisini açıyor. Arada cevap veren hiçbir şey yok.
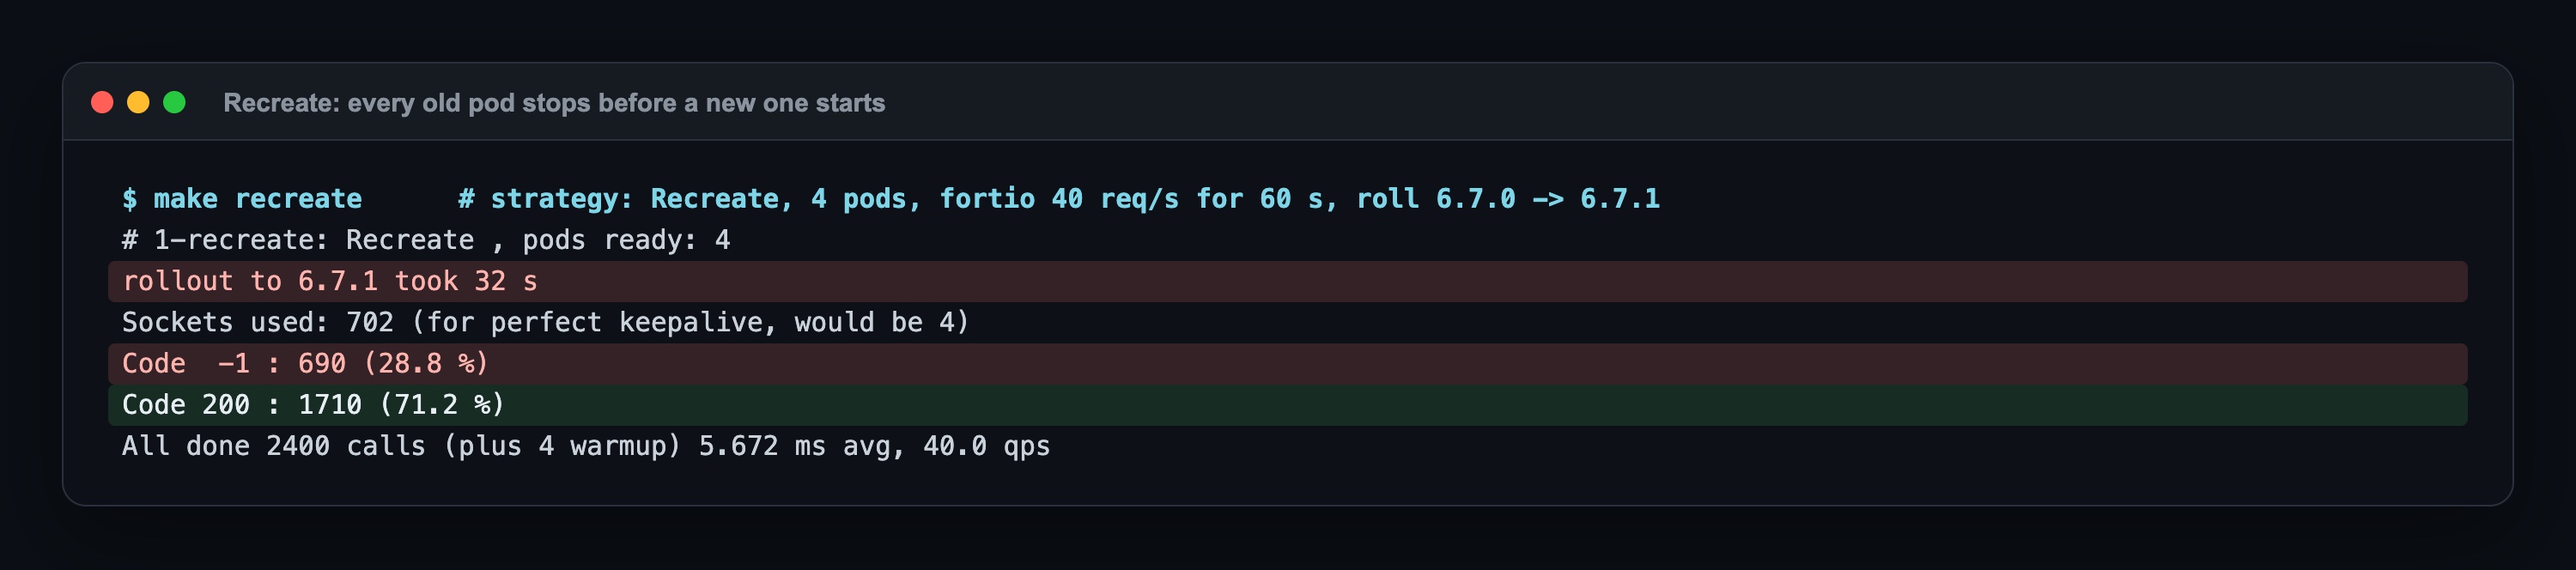
2.400 isteğin 690'ı hata verdi. Saniyede 40 istekle bu, yaklaşık 17 saniyelik kesinti demek. Code -1 fortio'da "HTTP cevabı hiç gelmedi" anlamına geliyor; dinleyen pod olmadığı için bağlantı reddedildi (connection refused). Recreate'i ancak iki sürümün asla aynı anda çalışmaması gerekiyorsa seçerim, o zaman da aradaki boşluğu hesaba katarım.
Adım 2: Readiness probe'suz RollingUpdate
Varsayılan strateji, probe yok. İlk yazılan Deployment'ların çoğu böyle.
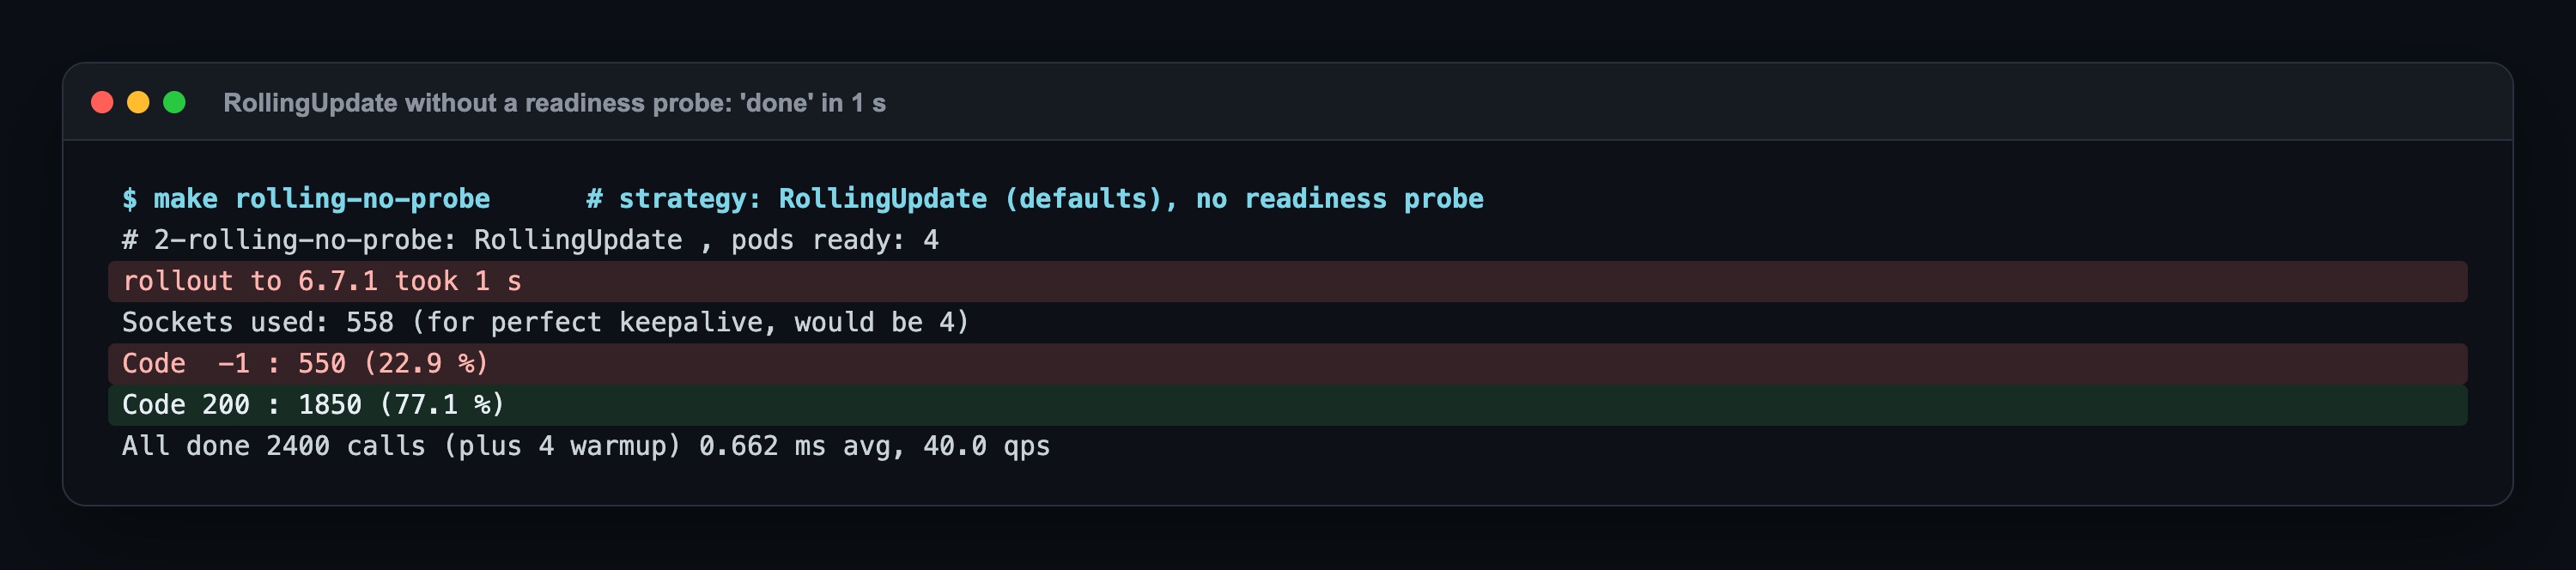
Rollout 1 saniyede bitti, ardından 550 istek hata verdi. Probe olmadığı için her yeni pod container'ı açılır açılmaz hazır sayıldı ve Kubernetes eski pod'ları hemen kapattı. Yeni pod'lar ise 8 saniye boyunca portu dinlemedi. Kağıt üstünde başarılı bir rolling update, pratikte hiç yapmamaktan kötü.
Adım 3: Readiness probe'lu RollingUpdate
Aynı rollout, iki değişiklikle: her saniye /readyz'ye bakan bir readiness probe ve maxSurge: 1, maxUnavailable: 0.
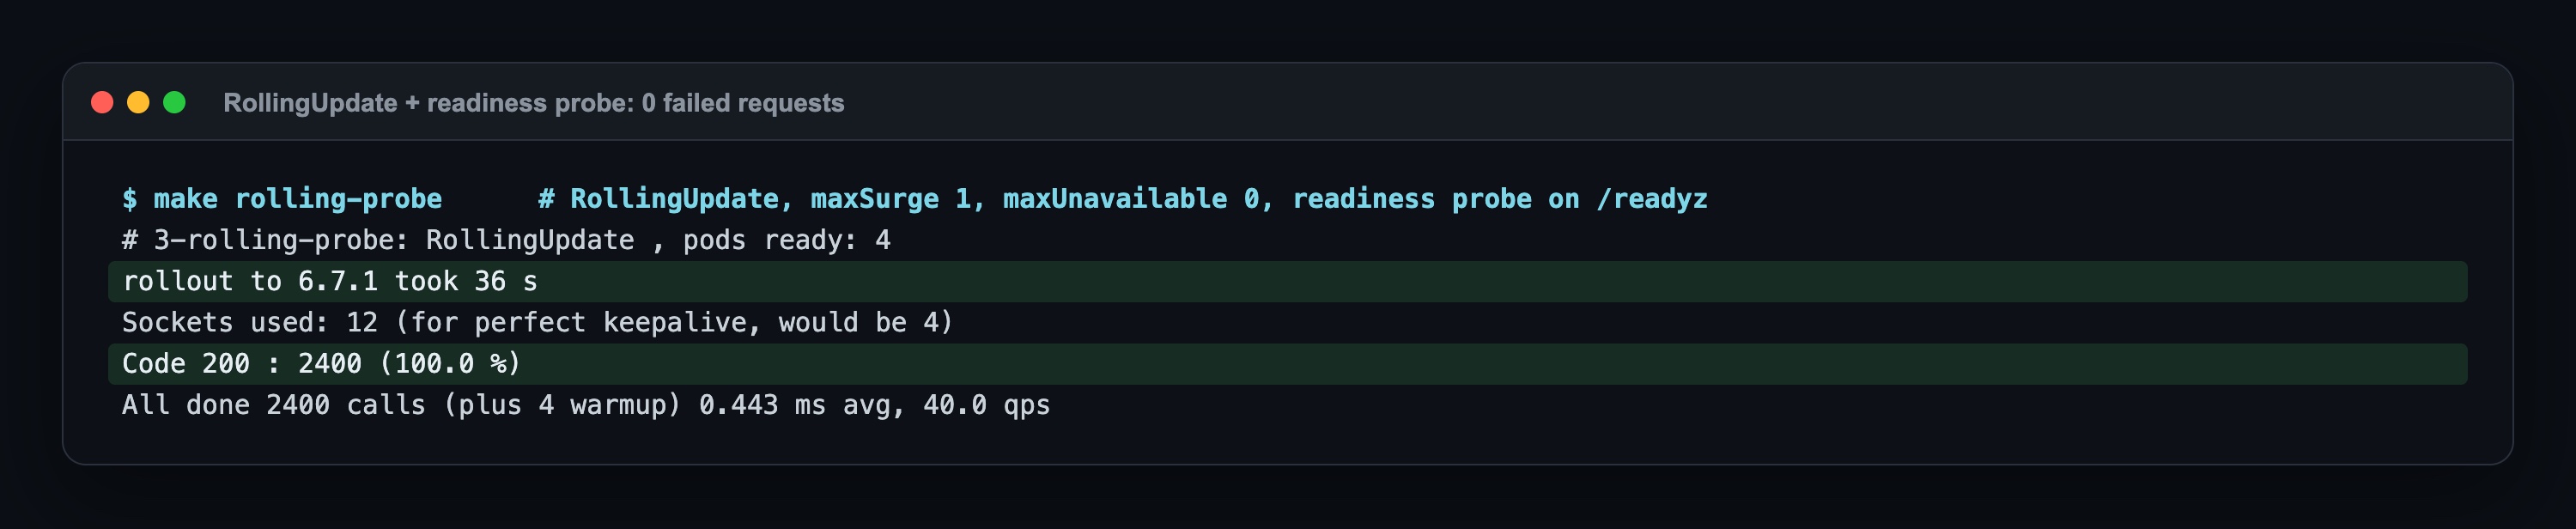
Tek bir istek bile düşmedi. Rollout bu sefer 1 değil 36 saniye sürdü, çünkü Kubernetes her yeni pod cevap vermeden eski pod'a dokunmadı ve bunu dört kez yaptı. Cevap veren pod sayısı hiçbir an dördün altına inmedi. Sıfır kesintinin gerçek bedeli bu: biraz zaman ve rollout boyunca bir fazla pod.
Adım 4: Blue/green
İki tam Deployment var: web-blue (6.7.0) ve web-green (6.7.1), ikisinde de dört pod. Service color: blue'yu seçiyor. Aynı yük altında selector'ı color: green yaptım, sonra geri aldım.
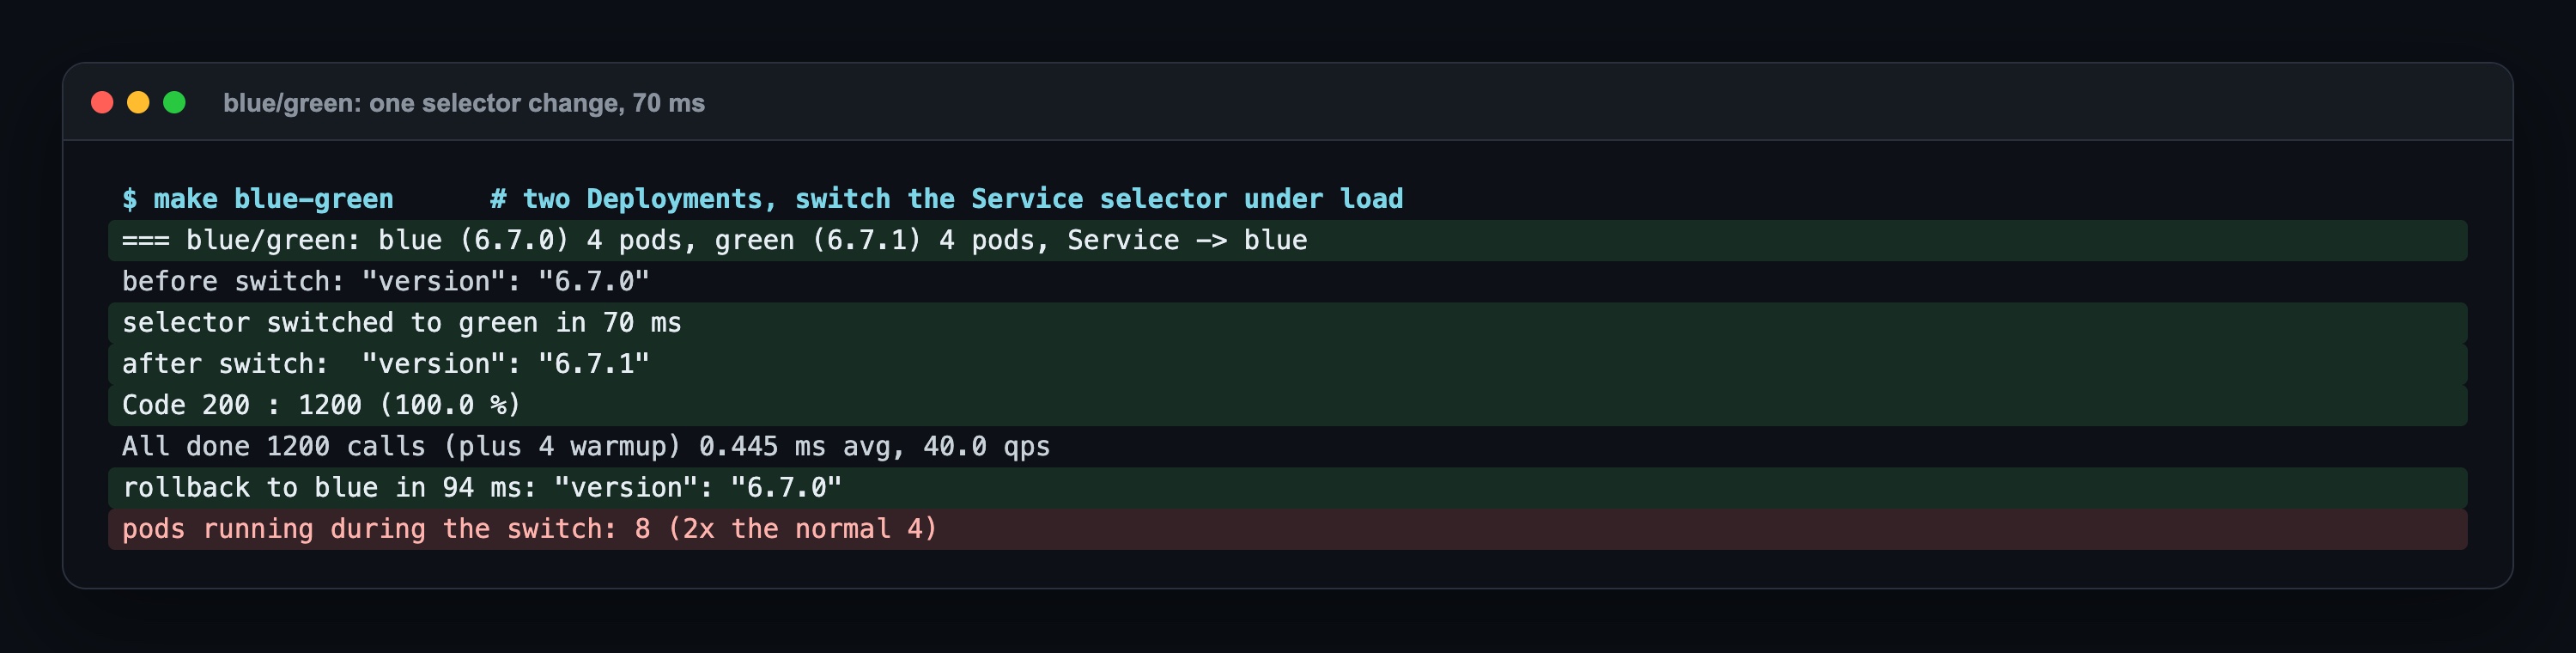
Geçiş 70 ms, geri dönüş 94 ms sürdü; o koşudaki 1.200 isteğin hepsi cevap aldı. Bedeli son satırda: dört pod'luk bir uygulama için sekiz pod çalışıyor. Blue/green'de anında geri dönebilmenin karşılığı, sürüm boyunca iki kat kapasite.
Adım 5: Canary
Dokuz pod 6.7.0'da, bir pod 6.7.1'de; hepsinde Service'in seçtiği label var. 200 istek attım ve cevabı hangi sürümün verdiğini saydım.
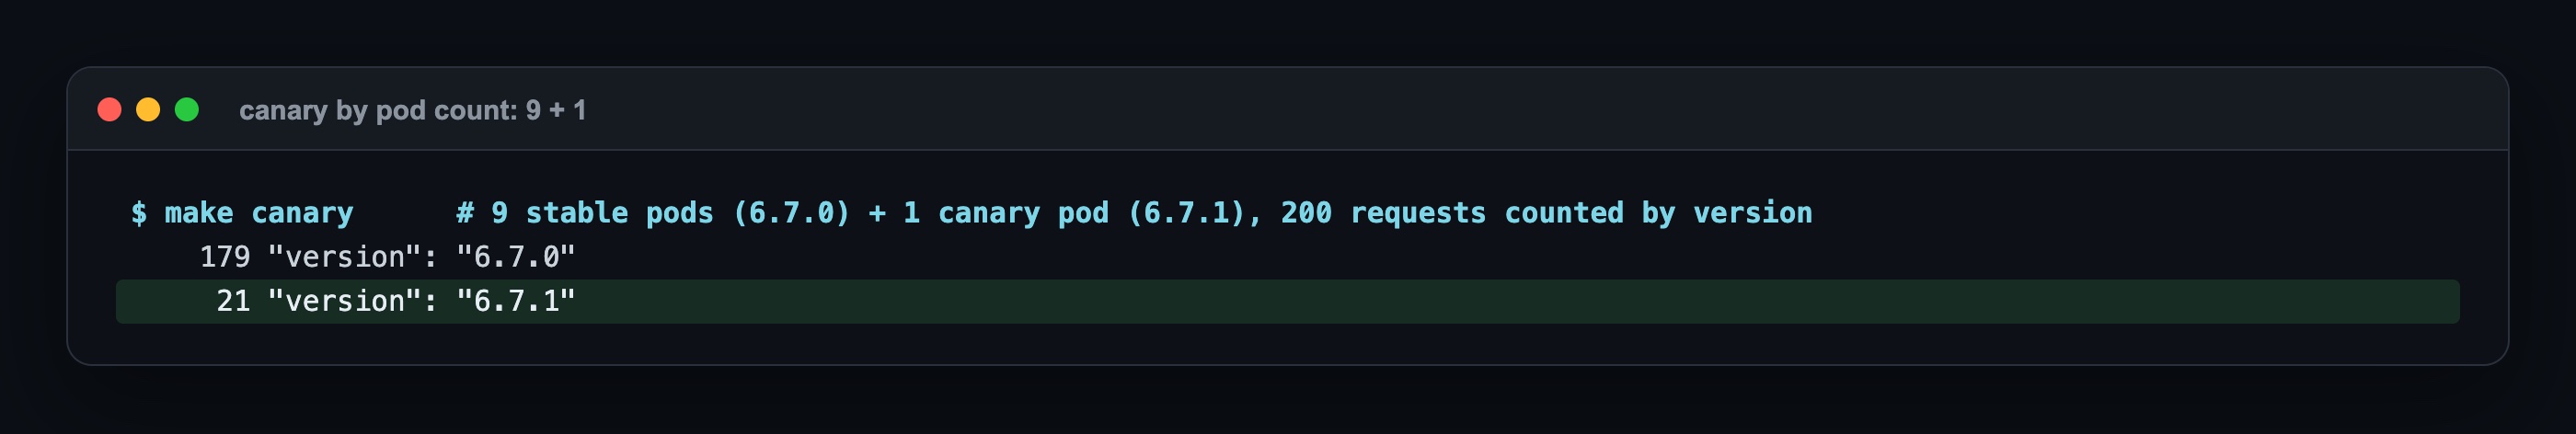
200 isteğin 21'i yeni sürüme gitti, yani pod sayısından beklenen yaklaşık %10. Bu basit canary'nin sınırı da burada: pay, pod sayısına bağlı. %1 isteseydim 99 stabil pod gerekirdi. Bunu ağırlıklı yönlendirme çözüyor; Gateway API yazısında tek bir HTTPRoute iki pod ile 200 isteğin 177'sini v1'e, 23'ünü v2'ye göndermişti.
Nerede patladı: 2 gerçek sürpriz
1. 1 saniyede "rollout tamamlandı", ardından 550 hata
Lab'ın en tehlikeli sonucu Adım 2'deki. kubectl rollout status bir saniye sonra başarılı dedi. Bunu bekleyen bir pipeline yeşil yanar ve yoluna devam ederdi. Oysa sonraki 8 saniyedeki bütün istekler hata verdi. Readiness probe yoksa Kubernetes uygulamanın henüz portu dinlemediğini bilemez. Deployment'larınızda readiness probe yoksa, "rollout başarılı" mesajı kullanıcılarınızın ne yaşadığı hakkında hiçbir şey söylemiyor.
2. Lazım olacağını düşündüğüm preStop burada hiçbir şey değiştirmedi
Sık verilen tavsiye bir preStop sleep eklemek. Gerekçe şu: pod SIGTERM'i, bütün node'lar ona trafik göndermeyi bırakmadan alabilir. Bunu dört şekilde denedim: podinfo'nun kendi düzgün kapanışıyla, SIGTERM gelir gelmez kapanan bir uygulamayla, saniyede 40 ve saniyede 400 istekle.
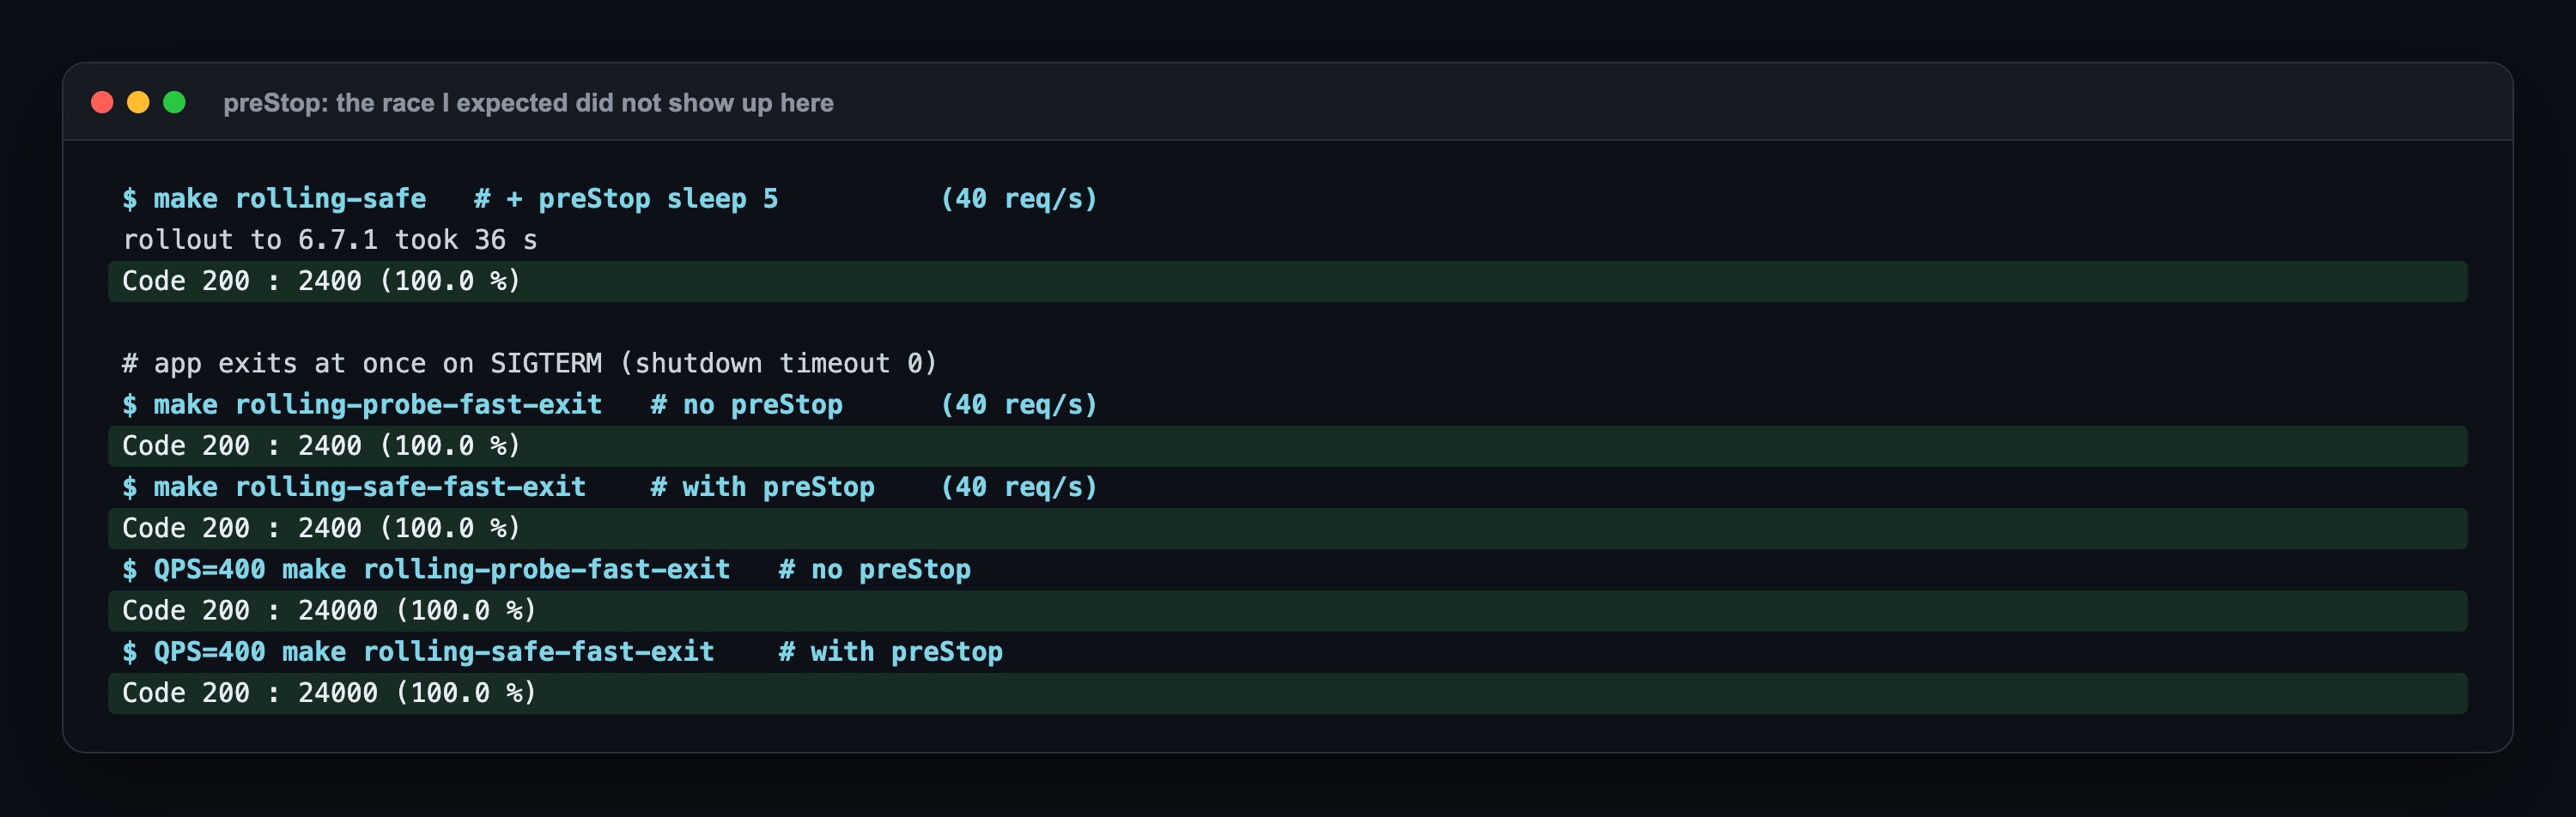
Bütün koşular %100 çıktı. Üç node'lu kind cluster'ında pod, uygulama kapanmadan önce Service'in hazır listesinden çıktı. Bu gerçek bir sonuç ama preStop'un işe yaramadığını göstermiyor. Büyük cluster'larda, backend listesini birkaç saniyede bir yenileyen dış load balancer ya da ingress controller varsa bu gecikme uzuyor. Hook'u lab'ın son manifest'inde bıraktım, ama bir fark ölçmediğim için fark var demiyorum.
Canary için bir not daha: düz Deployment'larda bölünme oranını replica sayıları belirliyor. 9 + 1 yaklaşık %10, 4 + 1 ise zaten %20. Oranı deploy etmeden önce replica sayısı olarak belirleyin ya da ağırlık destekleyen bir router kullanın.
Hangi strateji ne zaman?
| Durum | Seçim |
|---|---|
| Stateless bir web servisi, sıradan sürümler | Readiness probe'lu RollingUpdate, maxUnavailable: 0. Asıl kullanmanız gereken varsayılan bu. |
| Yeni sürüm herkese açılmadan gerçek trafikle denenmeli | Canary; küçük paylar gerekiyorsa ağırlıkla (Gateway API, service mesh, Argo Rollouts). |
| Saniyeler içinde geri dönebilmek şart ve bir süreliğine iki kat kapasiteyi kaldırabiliyorsunuz | Blue/green. |
| İki sürüm asla aynı anda çalışmamalı (exclusive bir lock, uyumsuz bir şema değişikliği) | Recreate, bakım penceresinde ve arada boşluk olacağını bilerek. |
Özet
- Zero-downtime deployment, sürüm değişirken hiçbir isteğin cevapsız kalmaması demek.
- Recreate'te 2.400 isteğin 690'ı düştü. Readiness probe'suz varsayılan rolling update'te 550'si düştü ve rollout yine de 1 saniyede başarılı göründü.
- Readiness probe ve
maxUnavailable: 0ile hata sayısı 0'a indi; bedeli 36 saniyelik rollout ve bir fazla pod. - Blue/green 70 ms'de geçti, 94 ms'de geri döndü, ama bu sırada iki kat pod çalıştı.
- Pod sayısıyla kurulan canary, trafiği de pod sayısına göre bölüyor: 9 + 1 pod ile isteklerin %10,5'i yeni sürüme gitti.
Kaynaklar: Kubernetes dokümanları Deployments (strategy, maxSurge, maxUnavailable), Configure Liveness, Readiness and Startup Probes, Pod Lifecycle (kapanış, preStop); fortio ve podinfo dokümantasyonu.
Serinin devamı
Bu yazı Temel Konular, Ölçerek serisinin ilki. Her yazıda mülakatlarda sık sorulan bir konuyu alıp lab'da ölçüyorum. Sıradaki yazı CMD ile ENTRYPOINT, ADD ile COPY farkı: Dockerfile'daki tek bir satır, docker stop'un 1 saniye mi 10 saniye mi süreceğini belirliyor. Önceki seri Tetragon Nedir? yazısıyla bitmişti.
Bu lab'ın kodu (kind config'i, altı strateji manifest'i, blue/green ve canary script'leri, fortio yük script'i ve Makefile) Buy Me a Coffee'deki Lab Access üyeleriyle paylaşılıyor; üye olduktan sonra repo daveti e-postayla geliyor: https://buymeacoffee.com/miraccanyilmaz/membership