Bare-metal bir cluster'da type: LoadBalancer yazılan ilk service, EXTERNAL-IP sütununda <pending> diye kalıyor ve orada sonsuza kadar bekliyor. Bulutta bu sütunu bulut sağlayıcının controller'ı dolduruyor; kendi sunucularımızda dolduran yok. Klasik cevap MetalLB kurmak. Bu yazıda aynı işi zaten cluster'da çalışan Cilium'a yaptırdım ve sonra en önemli soruyu sordum: IP'yi duyuran node ölürse ne oluyor? Lab'da ölçtüm: IP 17,8 saniyede başka node'a taşındı, ama isteklerin bir kısmı 47 saniye boyunca hata vermeye devam etti.
Bu, Cilium serisinin ikinci yazısı. Önce pod IP'lerinin nereden geldiğine (IPAM) bakıyorum, sonra service'lere dış IP veren LB-IPAM'e ve o IP'yi ağa duyuran L2 announcement'a. Her adım lab'daki gerçek çıktılarla.
Sorun ne, neden gerekli
Kendi sunucularında Kubernetes işleten ekiplerin ağ tarafında üç sorusu var.
Birincisi, dışarıdan erişilecek bir service'e IP kim verecek? NodePort çalışıyor ama kimse müşteriye :31666 portunu vermek istemez. LoadBalancer service'i de bulut dışında kendiliğinden IP almıyor.
İkincisi, o IP'yi ağdaki diğer makineler nasıl bulacak? Bir IP'yi bir havuzdan "vermek" yetmiyor; aynı ağdaki router ya da makine "bu IP kimde?" diye sorduğunda (ARP) birinin cevap vermesi gerekiyor. Ve o node ölürse başka biri cevaplamaya başlamalı.
Üçüncüsü pod IP'leri. Varsayılan kurulumda bütün pod'lar tek bir aralıktan IP alıyor. Birden fazla ekibin ya da müşterinin aynı cluster'ı paylaştığı yerde, güvenlik duvarı ekibi genelde şunu ister: "A müşterisinin pod'ları şu aralıktan çıksın, kuralı ona göre yazayım." Bu da pod IP'sini kimin, hangi havuzdan verdiğine bağlı.
Cilium üçünü de kendi içinde çözüyor: pod IP'leri için IPAM modları ve namespace başına havuz, service IP'leri için LB-IPAM, duyurmak için L2 announcement. Ayrı bir bileşen kurmak yok.
Cilium IPAM modları: pod IP'lerini kim dağıtıyor
IPAM (IP Address Management), her node'a hangi pod IP bloğunun düşeceğine ve pod'un o bloktan hangi IP'yi alacağına karar veren kısım. Cilium'da üç yaygın mod var ve farkları "bloğu kim kesiyor" sorusunda:
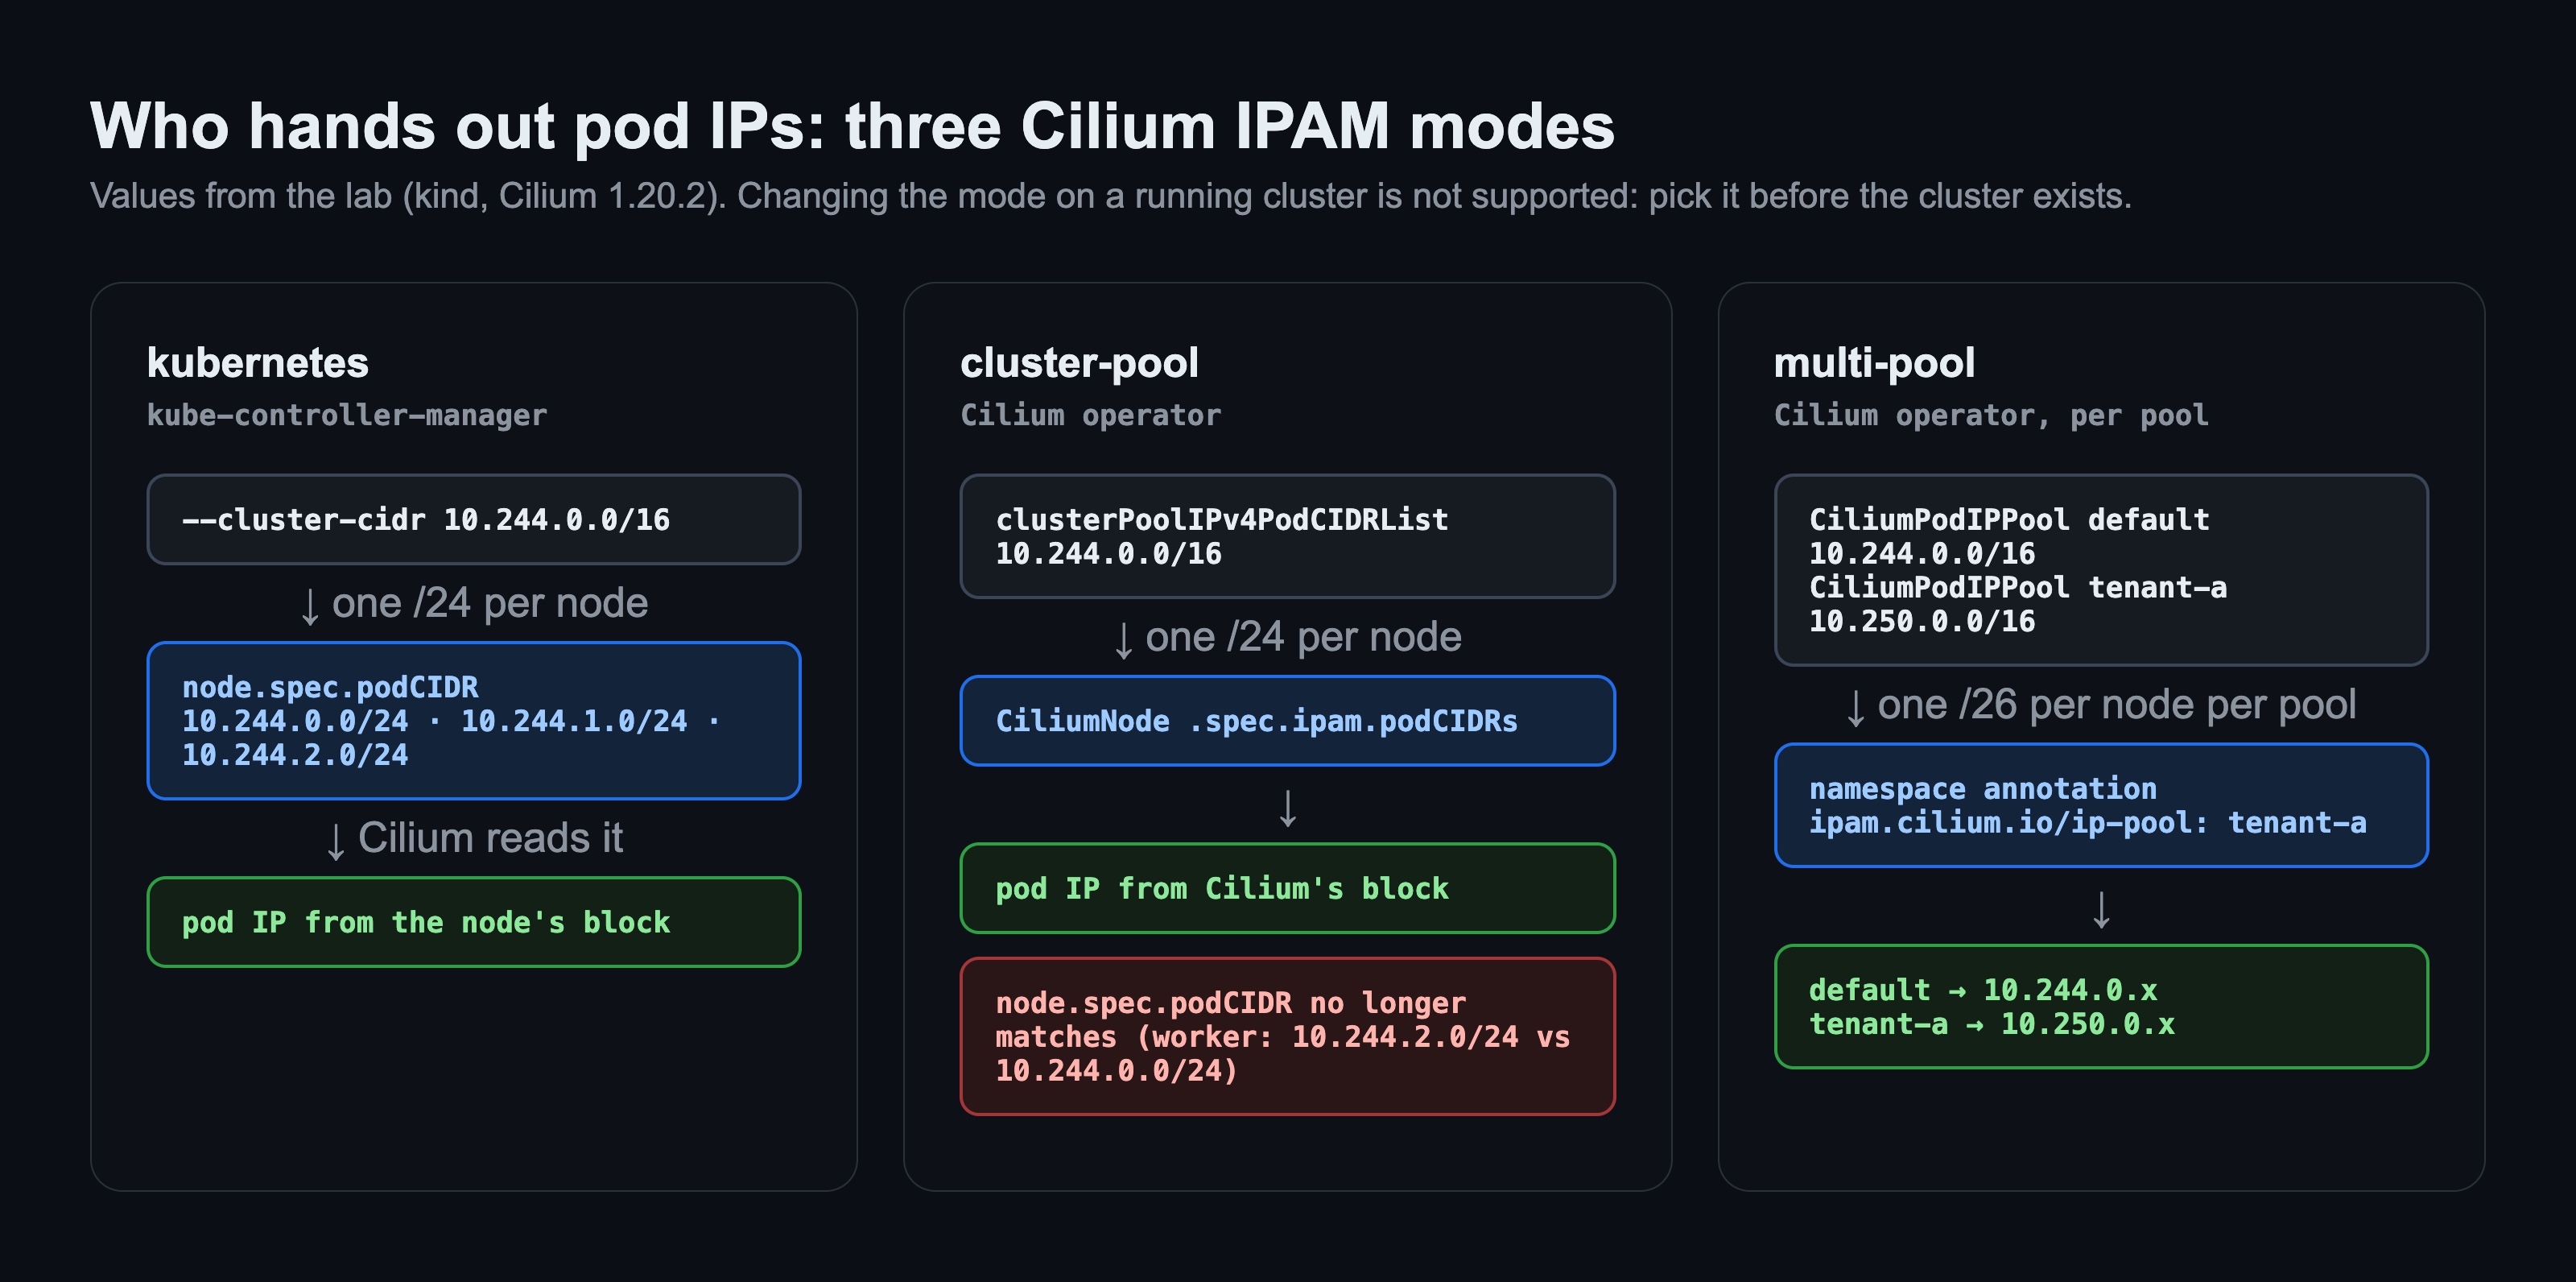
| Mod | Bloğu kim kesiyor | Ne zaman |
|---|---|---|
kubernetes |
Kubernetes (kube-controller-manager, node.spec.podCIDR) |
En basit kurulum; kind'ın, kubeadm'in varsayılanı |
cluster-pool |
Cilium operator (CiliumNode) |
Cilium'un varsayılanı; aralığı Kubernetes'ten bağımsız yönetmek |
multi-pool |
Cilium operator, her havuz için ayrı | Namespace ya da tenant başına farklı IP aralığı |
En önemli kural en başta: IPAM modu çalışan bir cluster'da değiştirilemez. Cilium dokümanı bunu açıkça desteklenmiyor diye yazıyor; aşağıda lab'da denediğimde ne olduğunu gösteriyorum. Modu cluster kurulmadan seçmek gerekiyor.
Lab: ne kurdum
Apple Silicon bir Mac'te, Colima (4 CPU / 8 GB, kernel 6.8) üzerinde, serinin ilk yazısındaki cluster'ın aynısı:
- kind v0.33 ile 1 control plane + 2 worker, Kubernetes v1.37.0, varsayılan CNI ve kube-proxy kapalı.
- Cilium 1.20.2, Helm ile, kube-proxy replacement açık. Her IPAM modu için ayrı, sıfırdan bir cluster.
- Son kurulum
multi-poolmodunda:defaulthavuzu10.244.0.0/16,tenant-ahavuzu10.250.0.0/16, ikisi de node başına/26. - LB-IPAM havuzu kind'ın Docker ağının (
172.20.0.0/16) içinden bir/24, L2 announcement sadece worker node'larda. - Demo: iki replikalı basit bir HTTP echo servisi, her worker'da bir pod olacak şekilde dağıtılmış.
Son kurulumun tamamı (cluster, Cilium, havuzlar, LB, L2) sıfırdan 117 saniye; doğrulama ve failover testi 66 saniye.
Adım 1 — kubernetes ve cluster-pool modu: aynı bloklar, farklı sahip
İlk iki cluster'ı aynı 10.244.0.0/16 aralığıyla kurdum; biri kubernetes, diğeri cluster-pool modunda. Her node'da iki yere baktım: Kubernetes'in node'a yazdığı podCIDR ve Cilium'un kendi CiliumNode kaydı.
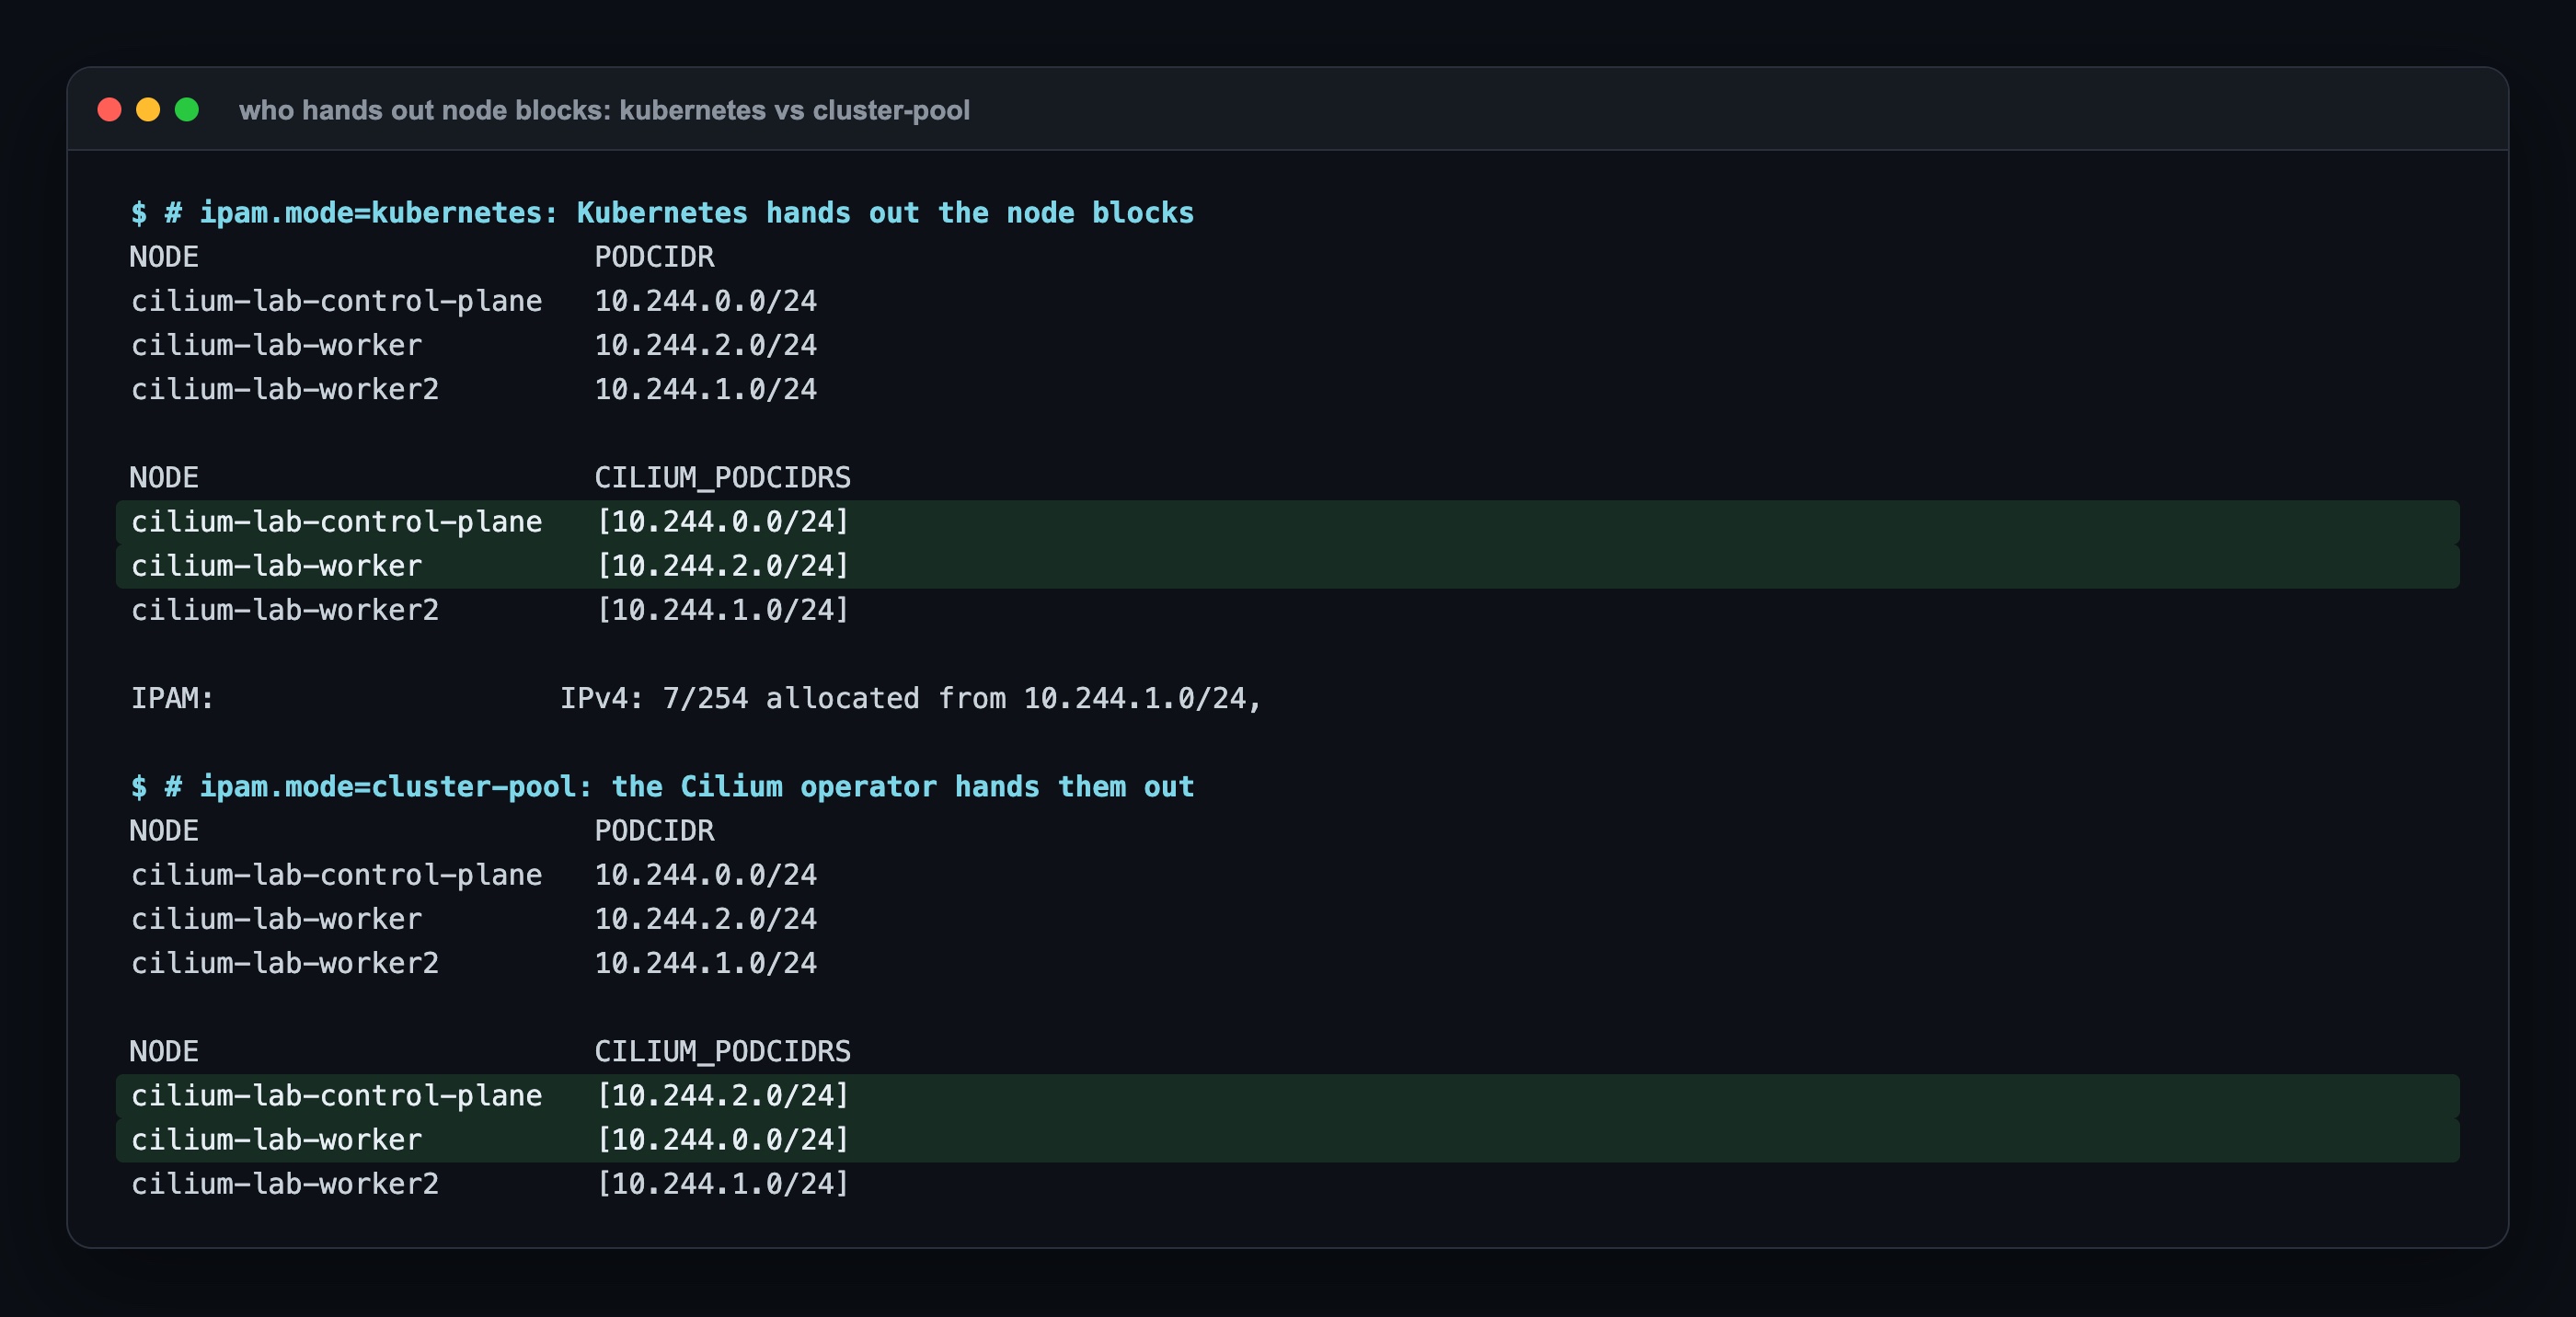
kubernetes modunda iki taraf birebir aynı: Cilium, Kubernetes'in verdiği bloğu okuyup kullanıyor. cluster-pool modunda ise bloklar Cilium operator'ından geliyor ve Kubernetes'in node'a yazdığıyla eşleşmiyor: worker için Kubernetes 10.244.2.0/24 diyor, pod'lar 10.244.0.0/24'ten IP alıyor. Hiçbir şey bozulmuyor, ama kubectl get nodes -o wide ya da node.spec.podCIDR'a bakan bir izleme aracı artık yanlış bilgi gösteriyor. Pod IP'sinin gerçek kaynağı CiliumNode.
Adım 2 — Çalışan cluster'da IPAM modunu değiştirmek: sessizce hiçbir şey olmuyor
Dokümanın "desteklenmiyor" dediği şeyi yine de denedim: kubernetes modunda çalışan bir cluster'a cluster-pool değerleriyle helm upgrade. Hata bekliyordum. Gelmedi:
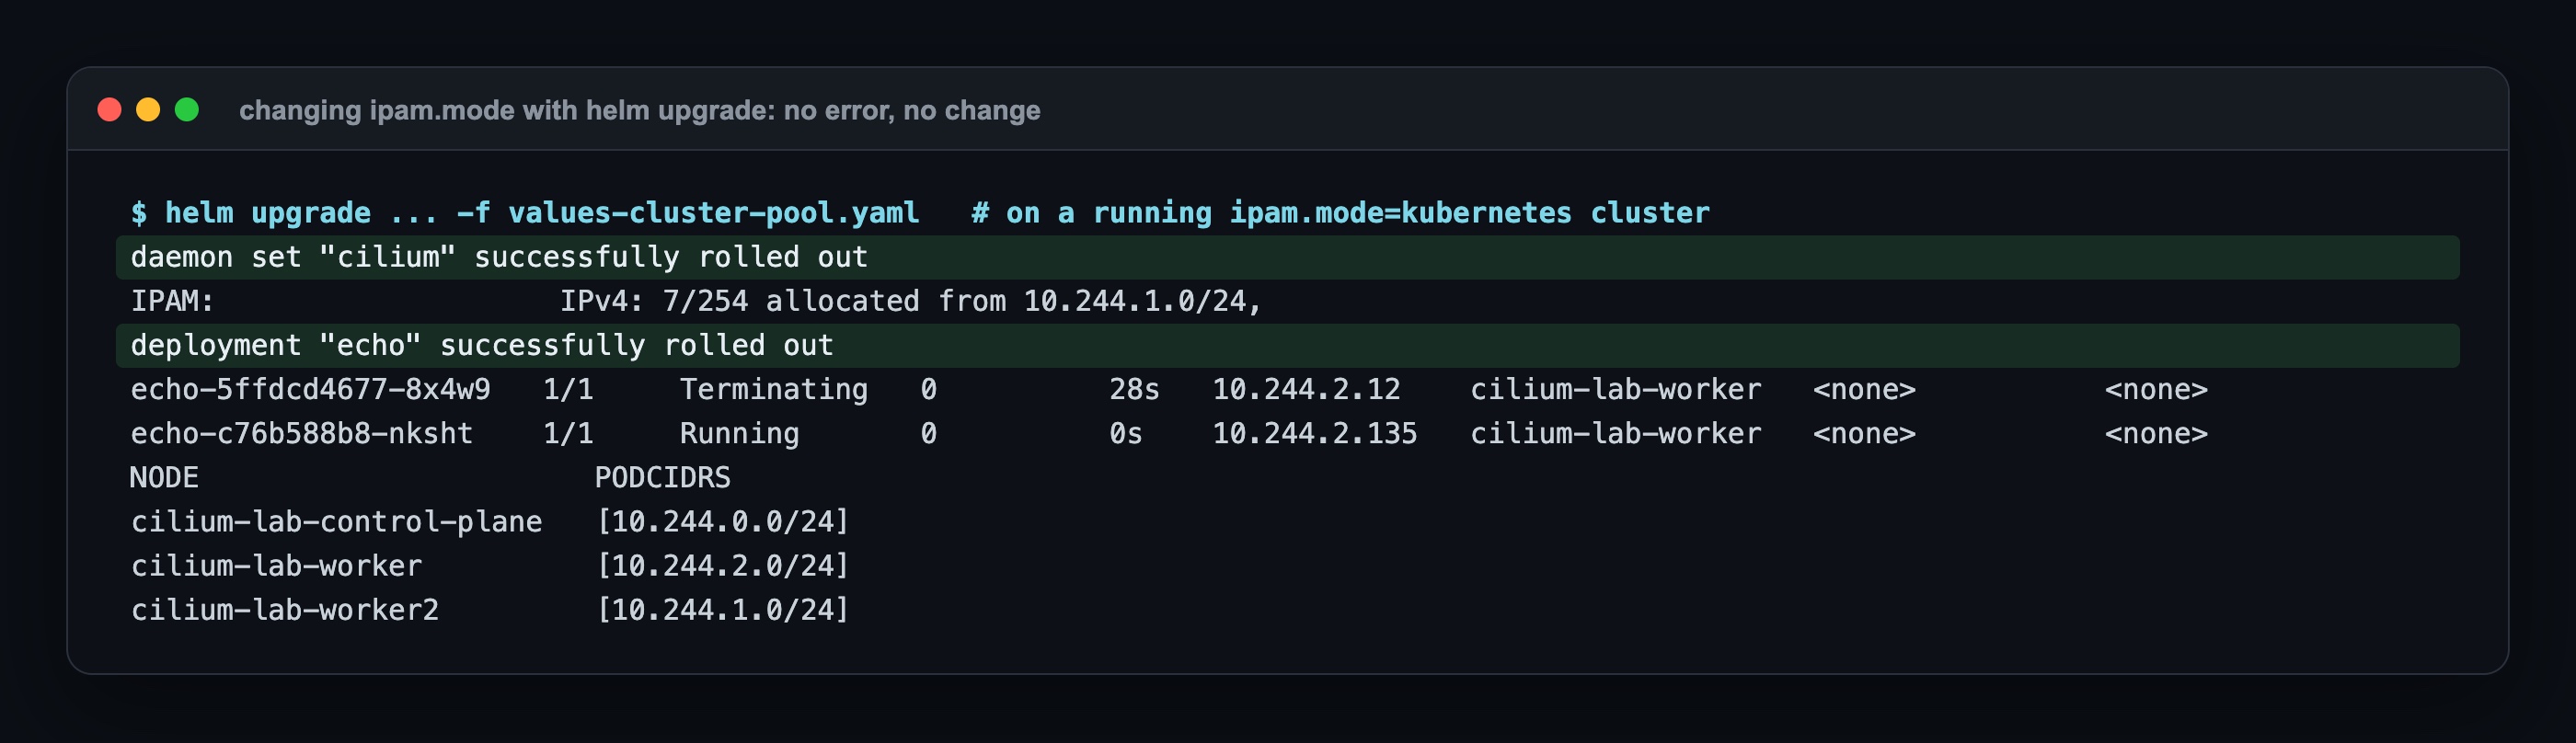
DaemonSet "successfully rolled out" dedi, yeni pod'lar Running oldu. Ama ajan hâlâ eski bloktan dağıtıyor ve CiliumNode'daki bloklar Kubernetes'inkilerle aynı kaldı. Yani mod değişmiş gibi görünüyor, değişmemiş. Daha kötüsü, bu "kısmen değişmiş" bir durumdan sonra bir node yeniden başlarsa ne olacağını kimse garanti etmiyor. Doğru yol yeni bir cluster açıp iş yüklerini taşımak; lab da her mod için cluster'ı sıfırdan kuruyor.
Adım 3 — multi-pool ve CiliumPodIPPool: namespace başına IP aralığı
multi-pool modunda Cilium birden fazla IP havuzu tutuyor. Havuz bir CiliumPodIPPool kaynağı; hangi namespace'in hangi havuzu kullanacağını da namespace'e yazılan bir annotation söylüyor. Lab'da tenant-a namespace'i 10.250.0.0/16 havuzuna bağlı, geri kalan her şey default havuzunda.
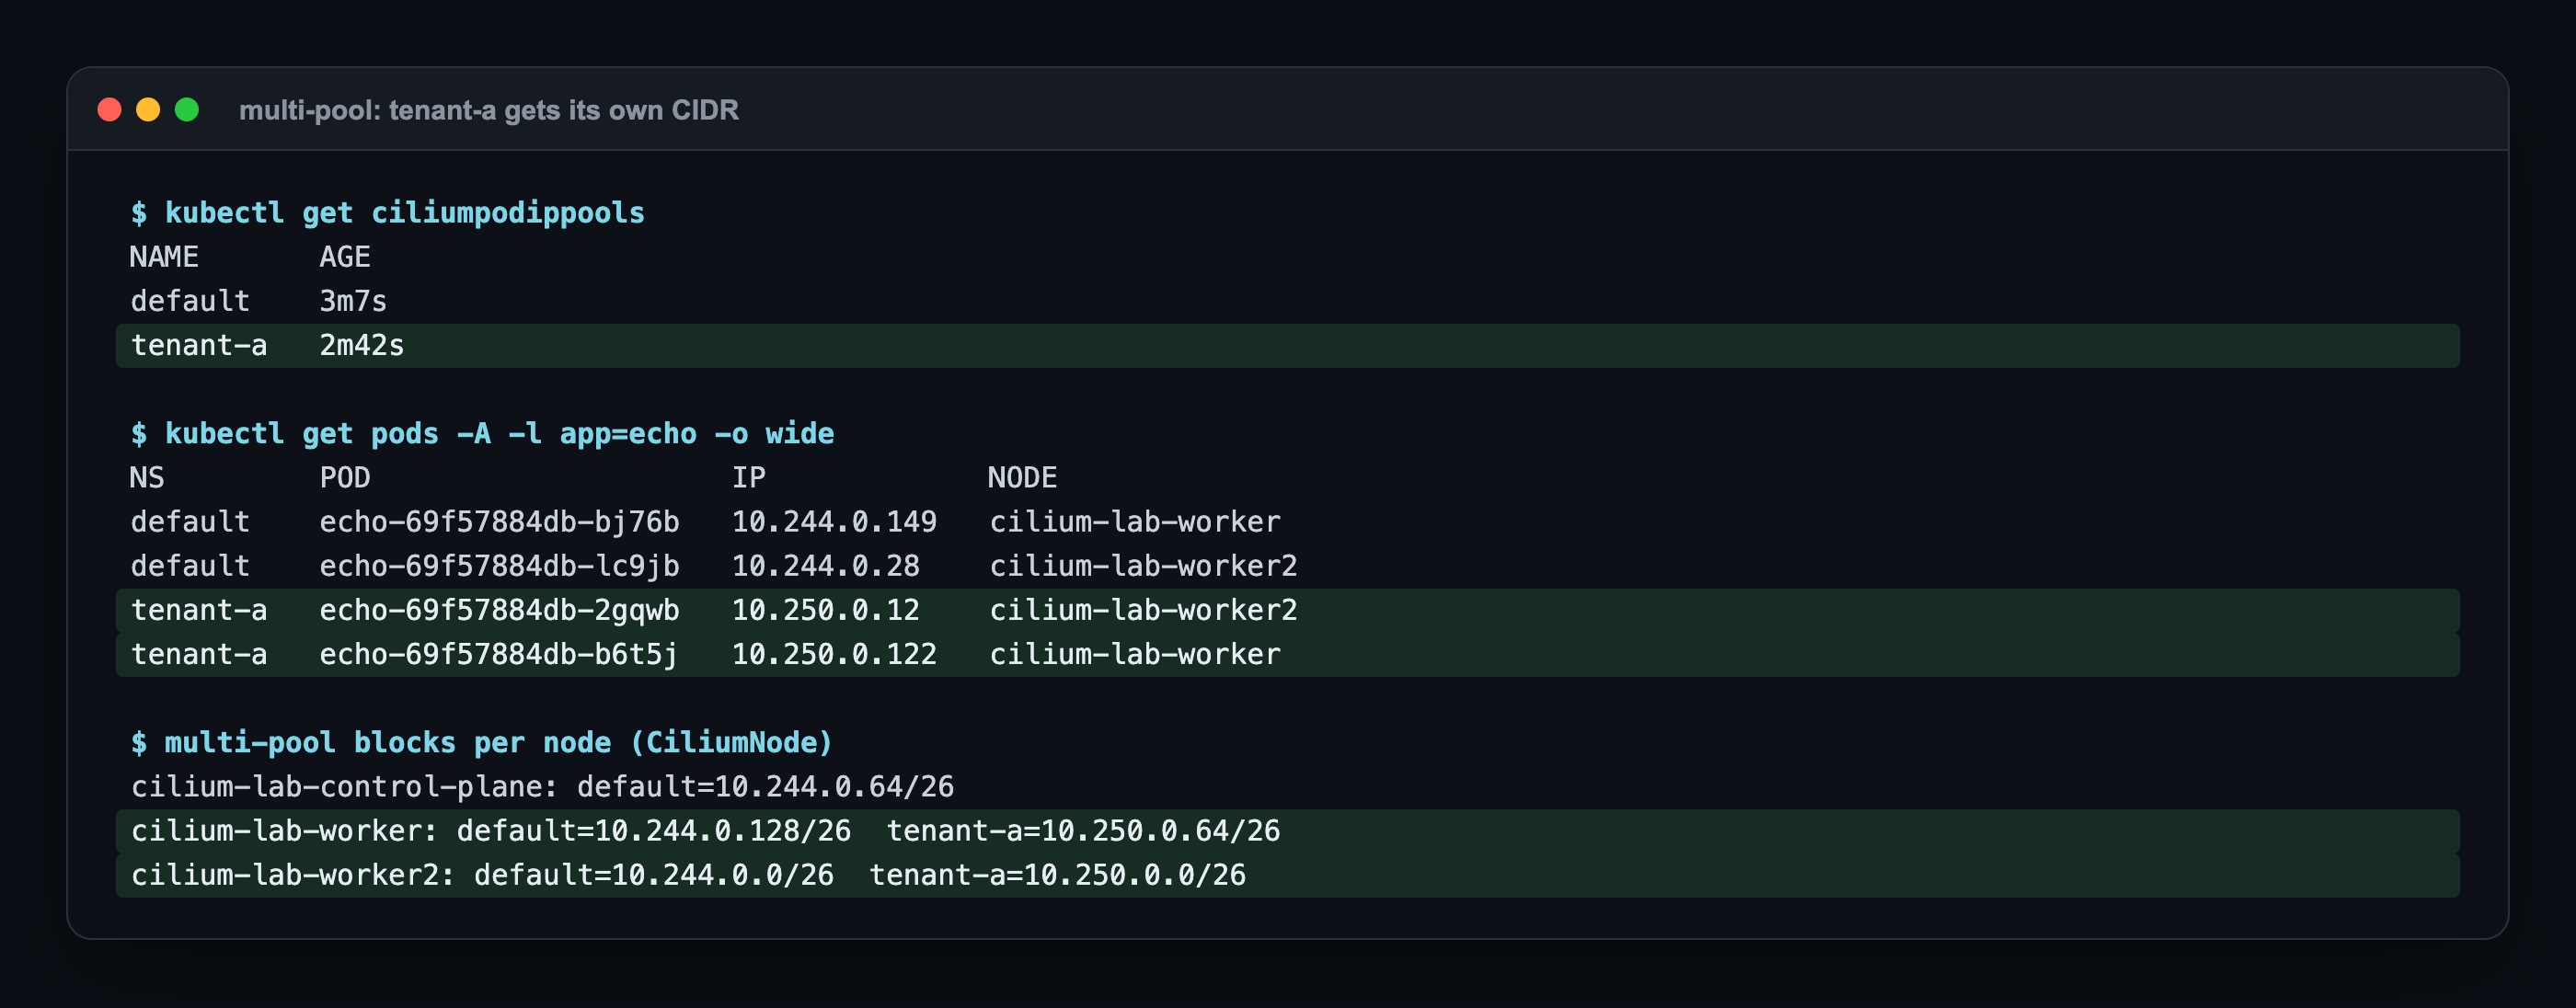
Aynı uygulamanın iki kopyası, aynı node'larda, iki farklı aralıktan IP aldı: default namespace'i 10.244.0.x, tenant-a 10.250.0.x. Operator her node'a her havuzdan ayrı bir /26 (62 IP) kesiyor; bir havuz o node'da hiç kullanılmıyorsa (control plane'de tenant-a gibi) blok da açılmıyor. Güvenlik duvarı ekibine artık "tenant-a = 10.250.0.0/16" diyebiliyorum.
İki not. Havuzların aralıkları birbiriyle çakışmamalı. Ve /26 bilerek küçük: bir node'da 62'den fazla pod olunca operator o node'a aynı havuzdan ikinci bir blok veriyor; büyük cluster'da daha geniş bir maske seçmek mantıklı.
Adım 4 — LB-IPAM: LoadBalancer service <pending>'den IP'ye
Pod IP'leri tamam; şimdi dışarıya açılan service. LB-IPAM, Cilium'un CiliumLoadBalancerIPPool kaynağındaki aralıktan LoadBalancer tipindeki service'lere IP veren kısmı. Ayrıca açılması gereken bir şey yok; havuzu tanımlamak yetiyor.
Kullanılabilir bir havuz yokken service bulut dışındaki her cluster'daki gibi <pending> kaldı. Havuz devreye girince birkaç saniye içinde 172.20.250.2 adresini aldı:
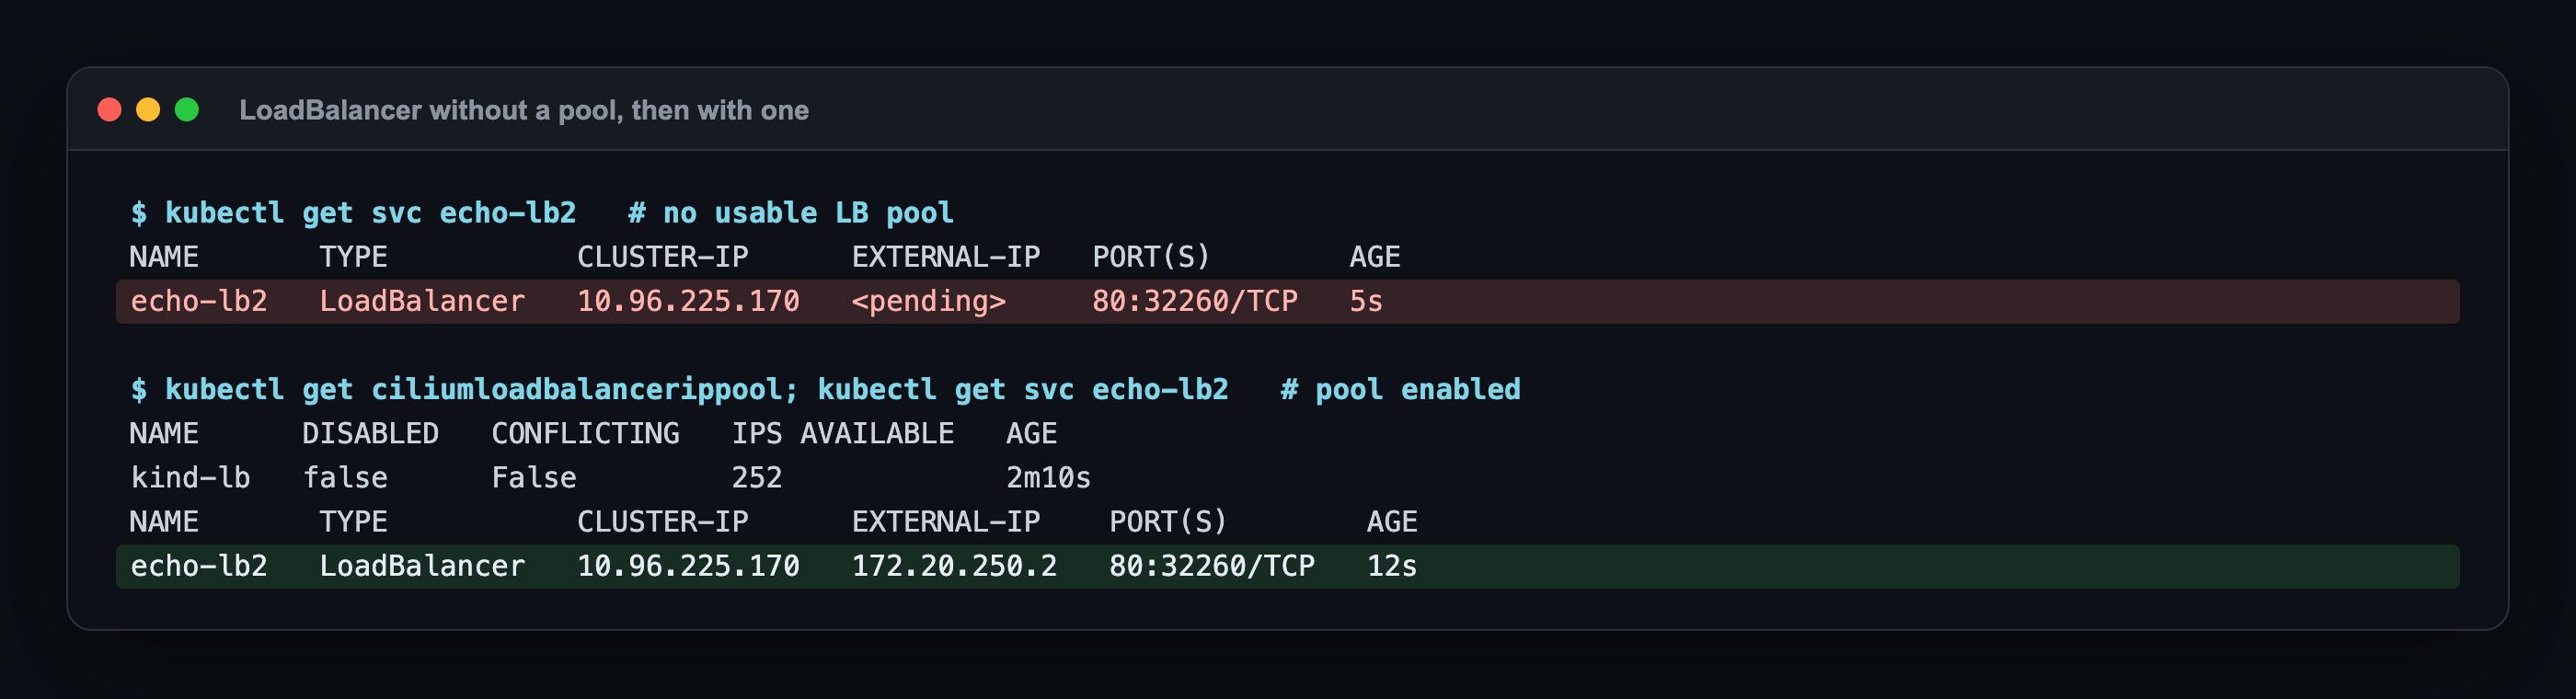
Havuz kind'ın Docker ağının içinden bir /24: 172.20.250.0/24. İlk ve son adresler kapalı, geriye 253 IP kalıyor. Gerçek bir ağda bu aralık, sunucuların bulunduğu VLAN'ın içinde ama DHCP'nin dağıtmadığı bir dilim olur. Bu seçim önemli; neden önemli olduğunu ilk denememde öğrendim (aşağıda, "Nerede patladı" #1).
Adım 5 — L2 announcement: IP'yi ağa duyurmak
IP'yi bir service'e yazmak, ağın o IP'yi bulabileceği anlamına gelmiyor. Aynı ağdaki bir makine 172.20.250.1'e paket göndermek istediğinde önce "bu IP hangi MAC adresinde?" diye ARP ile soruyor; biri cevap vermezse paket hiçbir yere gitmiyor.
Cilium'un L2 announcement özelliği bu cevabı veriyor. Her service için bir Kubernetes lease açılıyor; lease'i alan tek bir node o IP'nin ARP sorularına cevap veriyor. Hangi node'ların aday olacağını ve hangi arayüzden cevap verileceğini bir CiliumL2AnnouncementPolicy belirliyor; lab'da sadece worker'lar, eth0.
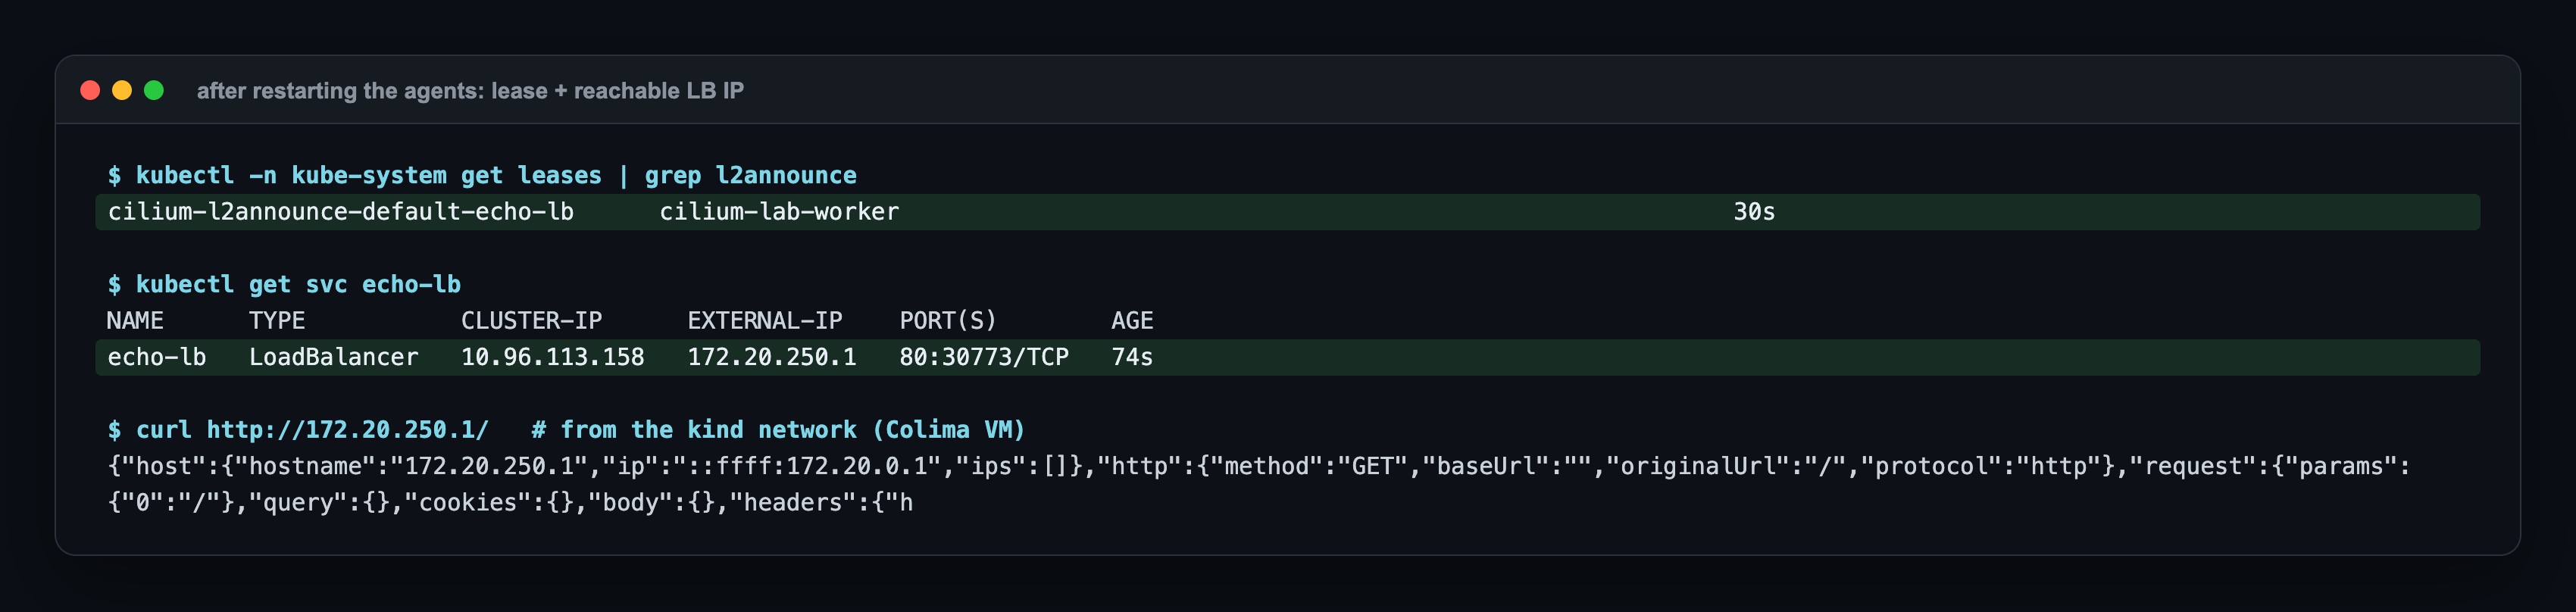
Lease bir worker'da, service 172.20.250.1'de ve kind ağından atılan curl echo servisinin cevabını aldı. Colima'da Mac, kind'ın Docker ağına doğrudan erişemiyor; bu yüzden istek Colima VM'inin içinden atılıyor. Gerçek bir ağda aynı VLAN'daki her makineden çalışır.
Ayarlardaki üç süre önemli, çünkü bir sonraki adımda ölçtüğüm şey bunlar: lease süresi 15 sn, yenileme için son tarih 5 sn, tekrar deneme 2 sn. Her service bir lease demek, her lease de API server'a düzenli bir yazma; service sayısı arttıkça Cilium'un API server'a istek limiti de yükseltilmeli (lab'da 20 QPS).
Adım 6 — L2 failover ölçümü: node ölünce ne oluyor
L2 announcement'ın asıl sorusu: IP'yi duyuran node giderse? Bunu ölçmek için bir script yazdım: echo pod'larının iki worker'a dağıldığını kontrol ediyor, LoadBalancer IP'sine saniyede yaklaşık 10 istek atıyor, lease'i tutan node'u docker kill ile anında öldürüyor ve olayların zamanını not ediyor.
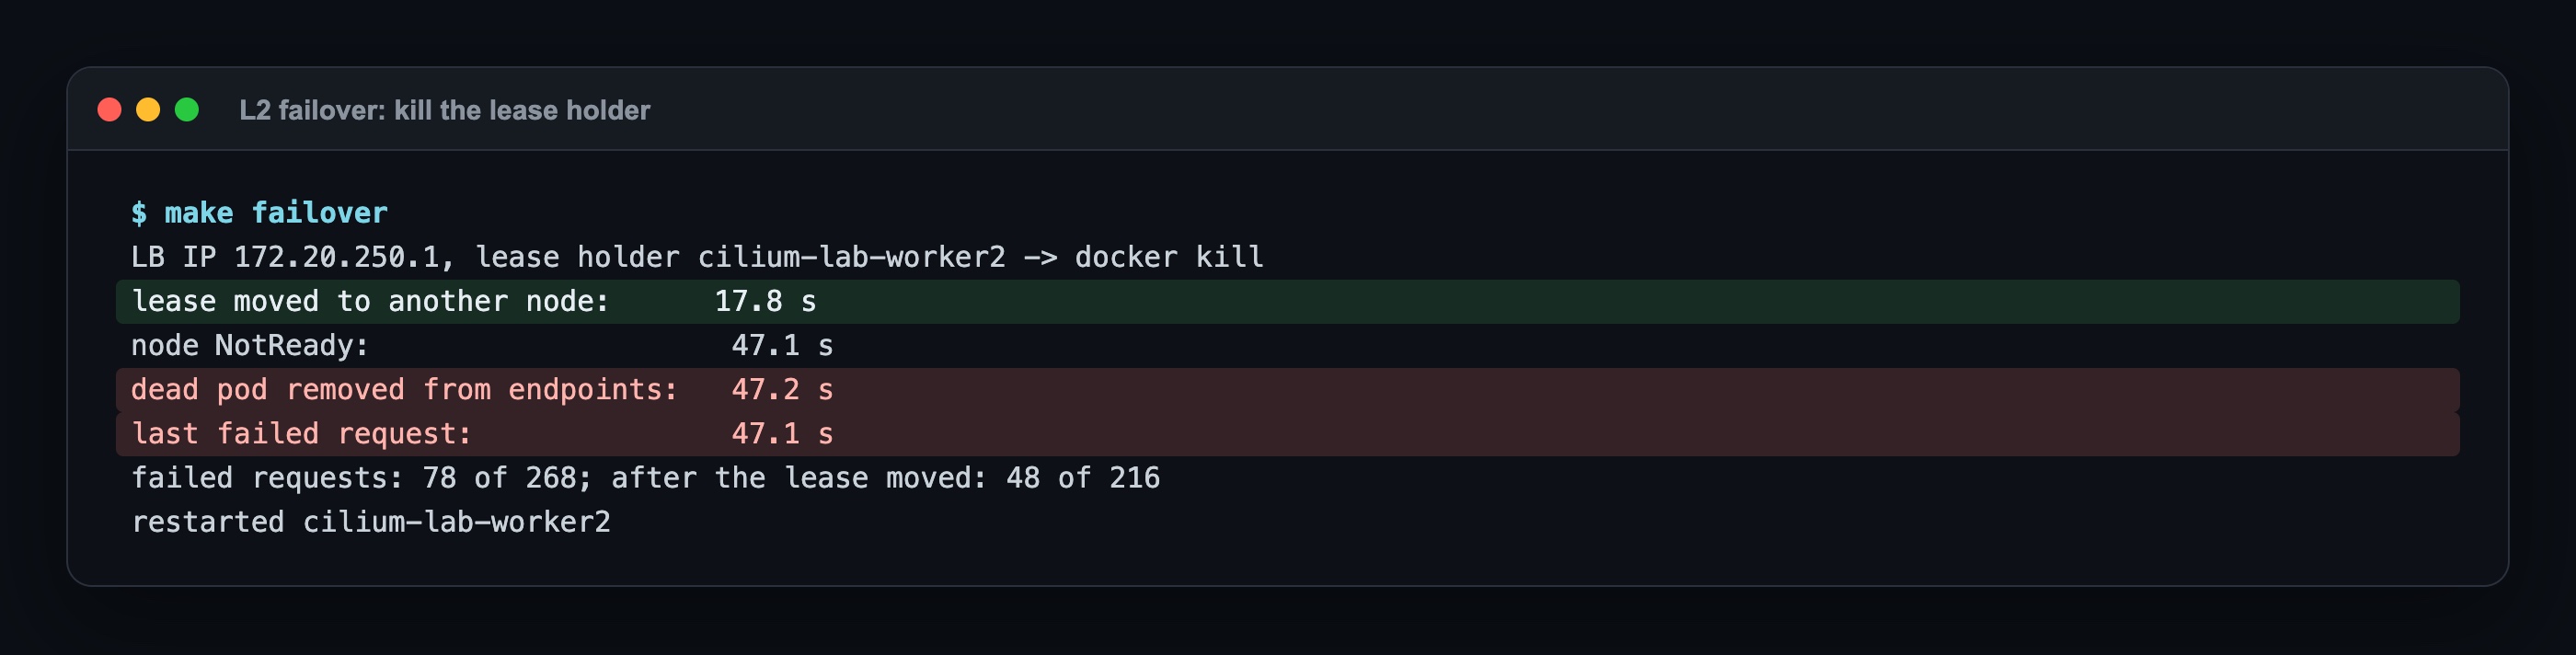
Sonuç beklediğimden ilginçti. Bu aslında iki ayrı failover:
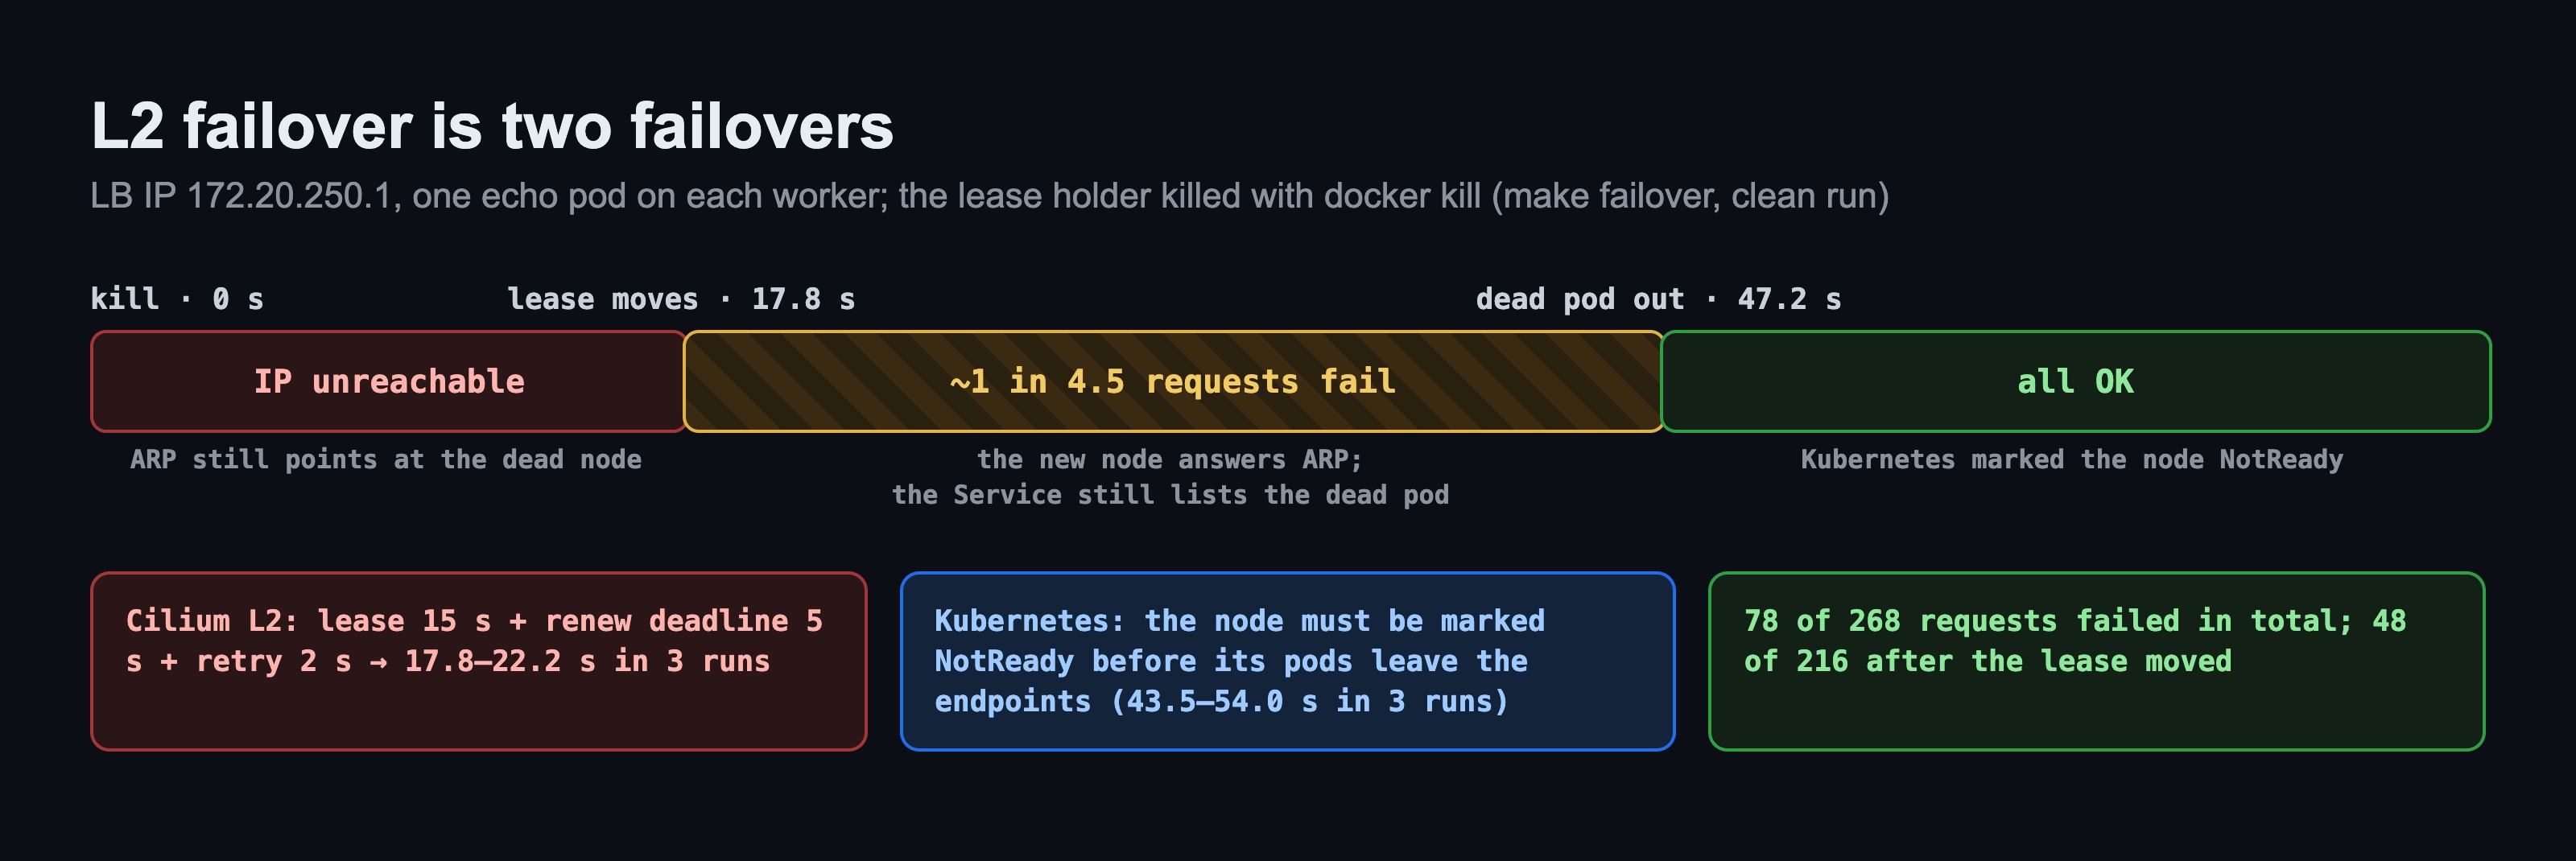
- Cilium'un failover'ı (0 → 17,8 sn). Ölü node lease'i yenileyemiyor; lease süresi dolunca başka bir worker alıyor ve ARP'a o cevap veriyor. Lease 15 sn, üstüne yenileme ve tekrar deneme süreleri geliyor; üç koşuda 17,8 ile 22,2 saniye arası ölçtüm. Bu sürede IP'ye hiç ulaşılamıyor.
- Kubernetes'in failover'ı (17,8 → 47,2 sn). IP artık canlı bir node'da, ama service'in endpoint listesinde ölü node'daki pod hâlâ duruyor. Kubernetes o pod'u ancak node'u
NotReadyişaretledikten sonra listeden çıkarıyor; bu da kubelet'ten haber alamadığı süre dolunca oluyor. O ana kadar isteklerin bir kısmı ölü pod'a gidip hata veriyor: lease taşındıktan sonra bile 216 istekten 48'i.
Testi üç kez koştum. Diğer iki koşuda lease 18,9 ve 22,2 sn'de taşındı, endpoint'ler 43,5 ve 54,0 sn'de temizlendi, hata veren istek 265'te 71 ve 269'da 88 oldu. Sayılar oynuyor, şekil hep aynı: önce yaklaşık 20 saniye tam kesinti, sonra yarım dakika kadar kısmi hata.
Buradan çıkan pratik sonuç: L2 announcement ayarlarını sıkılaştırmak sadece ilk bölümü kısaltıyor. Toplam kesinti süresini belirleyen, Kubernetes'in ölü node'u ne kadar sürede fark ettiği. Pod'ların readiness probe'u da bu ikinci bölümü kısaltmıyor, çünkü ölü node'daki kubelet probe sonucunu zaten raporlayamıyor.
Nerede patladı: 4 gerçek hata
1. level=fatal msg="exit status 28": LB havuzu Docker ağının dışındaydı
Taslağımda LB havuzu 172.18.250.0/24 idi, çünkü kind'ın Docker ağı birçok makinede 172.18.0.0/16. Bu makinede değil: Colima'da ağ 172.20.0.0/16. Cilium buna hiç itiraz etmedi; service havuzdan 172.18.250.1'i aldı, EXTERNAL-IP sütunu dolu ve doğru görünüyordu. Ama o adres ağda kimsenin yolu olmayan bir aralıkta; curl 5 saniye bekleyip zaman aşımına düştü.
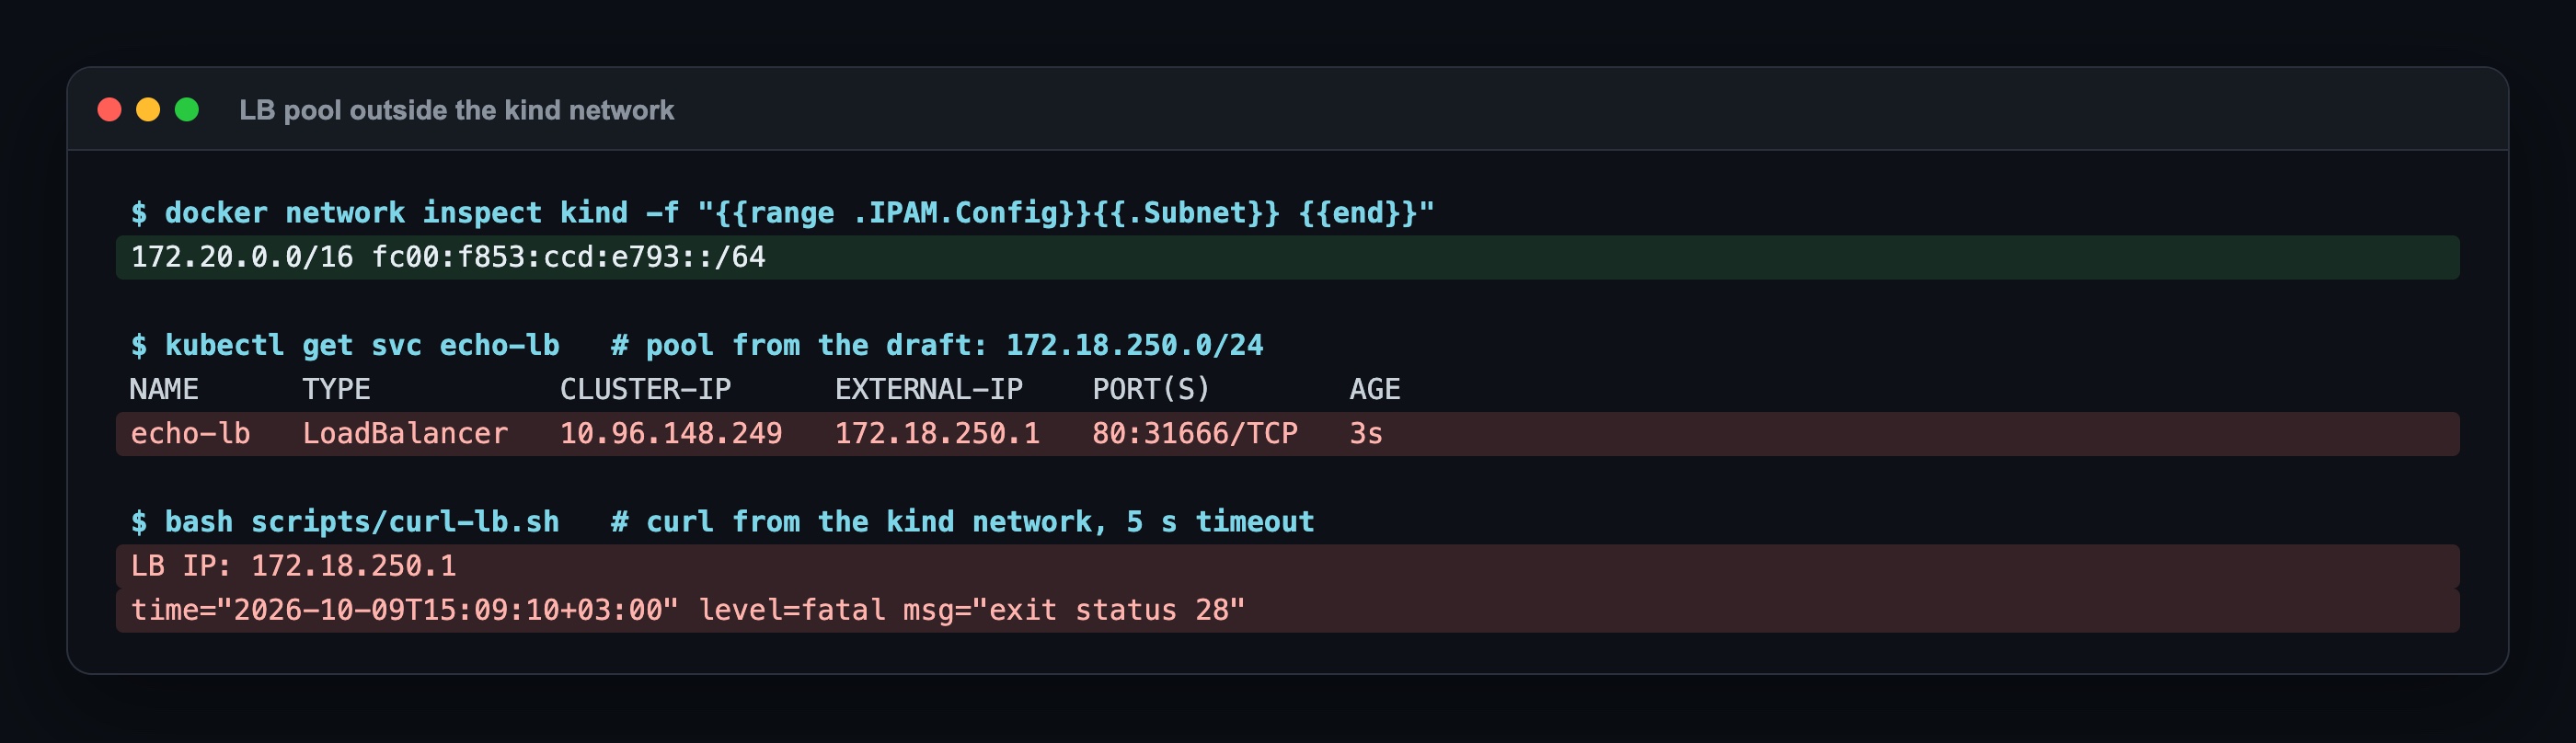
Ders: LB-IPAM bir IP'yi "verdi" diye o IP'nin erişilebilir olduğunu söylemiyor. Havuz, node'ların bulunduğu L2 ağının içinde olmalı. Lab artık havuzu kind ağının adresinden türetiyor.
2. Mismatch found ... enable-l2-announcements actual=false: helm upgrade ajanları yeniden başlatmıyor
L2 announcement'ı çalışan bir cluster'da helm upgrade ile açtım. Upgrade başarılı, ama hiç lease oluşmadı ve IP'ye ulaşılamadı. Ajanın log'unda sebep yazıyordu:
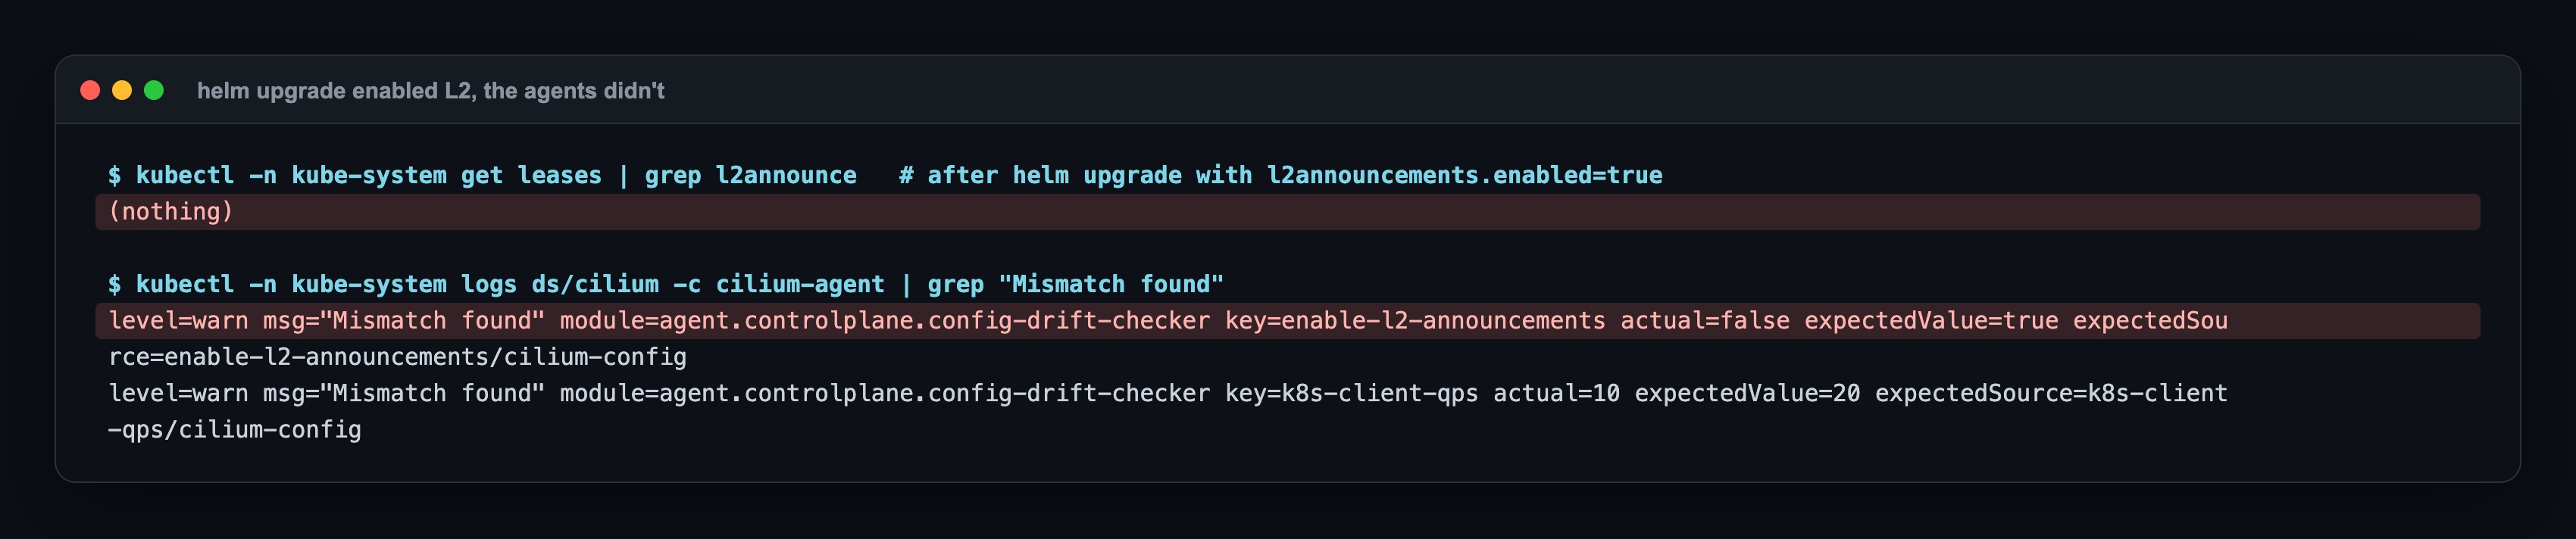
helm upgrade Cilium'un ConfigMap'ini güncelliyor, ama çalışan ajanlar bu ayarı sadece açılırken okuyor. Ajan farkı görüp uyarı da yazıyor, ama kendini yeniden başlatmıyor. Cilium ajanlarını ve operator'ı rollout restart ile yeniden başlatınca lease birkaç saniyede oluştu. Lab bu adımı artık kendisi yapıyor.
3. Mod değişikliği hata vermedi
Adım 2'deki durum ayrı bir madde olarak burada da durmalı, çünkü en sessiz olanı bu: kubernetes'ten cluster-pool'a helm upgrade başarılı göründü ve hiçbir şey değişmedi. Hata yok, uyarı yok. IPAM modunu cluster kurulmadan seçin.
4. İlk failover ölçümüm L2'yi değil pod'un yeniden kurulmasını ölçüyordu
İlk denemede iki echo pod'u da öldürdüğüm node'daydı. Lease taşındı, ama arkada cevap verecek pod kalmadı; ölçtüğüm şey Kubernetes'in pod'u başka node'da yeniden kurma süresiydi. Lab artık pod'ları iki worker'a dağıtıyor ve node'u öldürmeden önce her worker'da bir pod olduğunu kontrol ediyor.
Doğrulama
Lab'ın doğru kurulduğunu şunlar gösteriyor:
cilium-dbg status:KubeProxyReplacement: True, routingNative, host routingBPF.kubectl get ciliumpodippools:defaultvetenant-a;defaultnamespace'indeki pod'lar10.244.x,tenant-a'dakiler10.250.x.kubectl get ciliumloadbalancerippool:kind-lb,CONFLICTING False.echo-lbservice'ininEXTERNAL-IP'si172.20.250.1.cilium-l2announce-default-echo-lblease'i bir worker'da.- kind ağından
curl http://172.20.250.1/echo cevabını döndürüyor. - Failover: lease yaklaşık 20 saniyede başka worker'a taşınıyor, ölü pod endpoint'lerden çıktıktan sonra istekler hatasız.
Kaynaklar: Cilium dokümanları IP Address Management (IPAM), Multi-Pool (Beta), LoadBalancer IP Address Management (LB IPAM) ve L2 Announcements / L2 Aware LB (Beta); Kubernetes Nodes (node heartbeats ve node controller), Service (type: LoadBalancer).
Seride sonraki
Bu, Cilium Uçtan Uca serisinin ikinci yazısı. Sonraki: CiliumNetworkPolicy ile Default-Deny'a Giden Yol: L3/L4, DNS ve L7 HTTP Kuralları. Önceki yazı: Cilium Nedir: kube-proxy'siz Kubernetes, eBPF ve Hubble ile Uygulamalı Giriş.
Bu lab'ın kodu (kind yapılandırması, her IPAM modu için Cilium değerleri, havuzlar, failover script'i ve Makefile) Buy Me a Coffee'deki Lab Access üyeleriyle paylaşılıyor; üye olduktan sonra repo daveti e-postayla geliyor: https://buymeacoffee.com/miraccanyilmaz/membership