"HA Argo CD" genelde values dosyasında tek bir şey demek: birkaç bileşenin yanına replicas: 2. İlk seferinde ben de öyle yaptım. Yaşadığım ilk gerçek kesinti, toplu bir sync sırasında belleği biten bir repo-server'dı; üç sağlıklı API server replica'sı da olanı seyrediyordu. Sorun hiçbir zaman API server'da değildi.
Bu yazıda Argo CD'yi dört node'lu bir kind cluster'ında HA modda kuruyoruz, geri kalan her şeyi tek bir root Application'a (app-of-apps) veriyoruz, sonra bilerek bozuyoruz: Redis master'ı, bir repo-server'ı ve application controller'ın çalıştığı node'u. Her arızanın süresini ölçüyoruz. İkisi fark edilmeden geçiyor (6 saniye ve 1 saniye). Üçüncüsü, elle bir taint ekleyene kadar bütün reconciliation'ı yedi dakika durdurdu. Sonunda Argo CD'nin hangi parçalarının gerçekten failover ettiğini, hangisinin etmediğini ve bu konuda ne yapılacağını bileceksiniz.
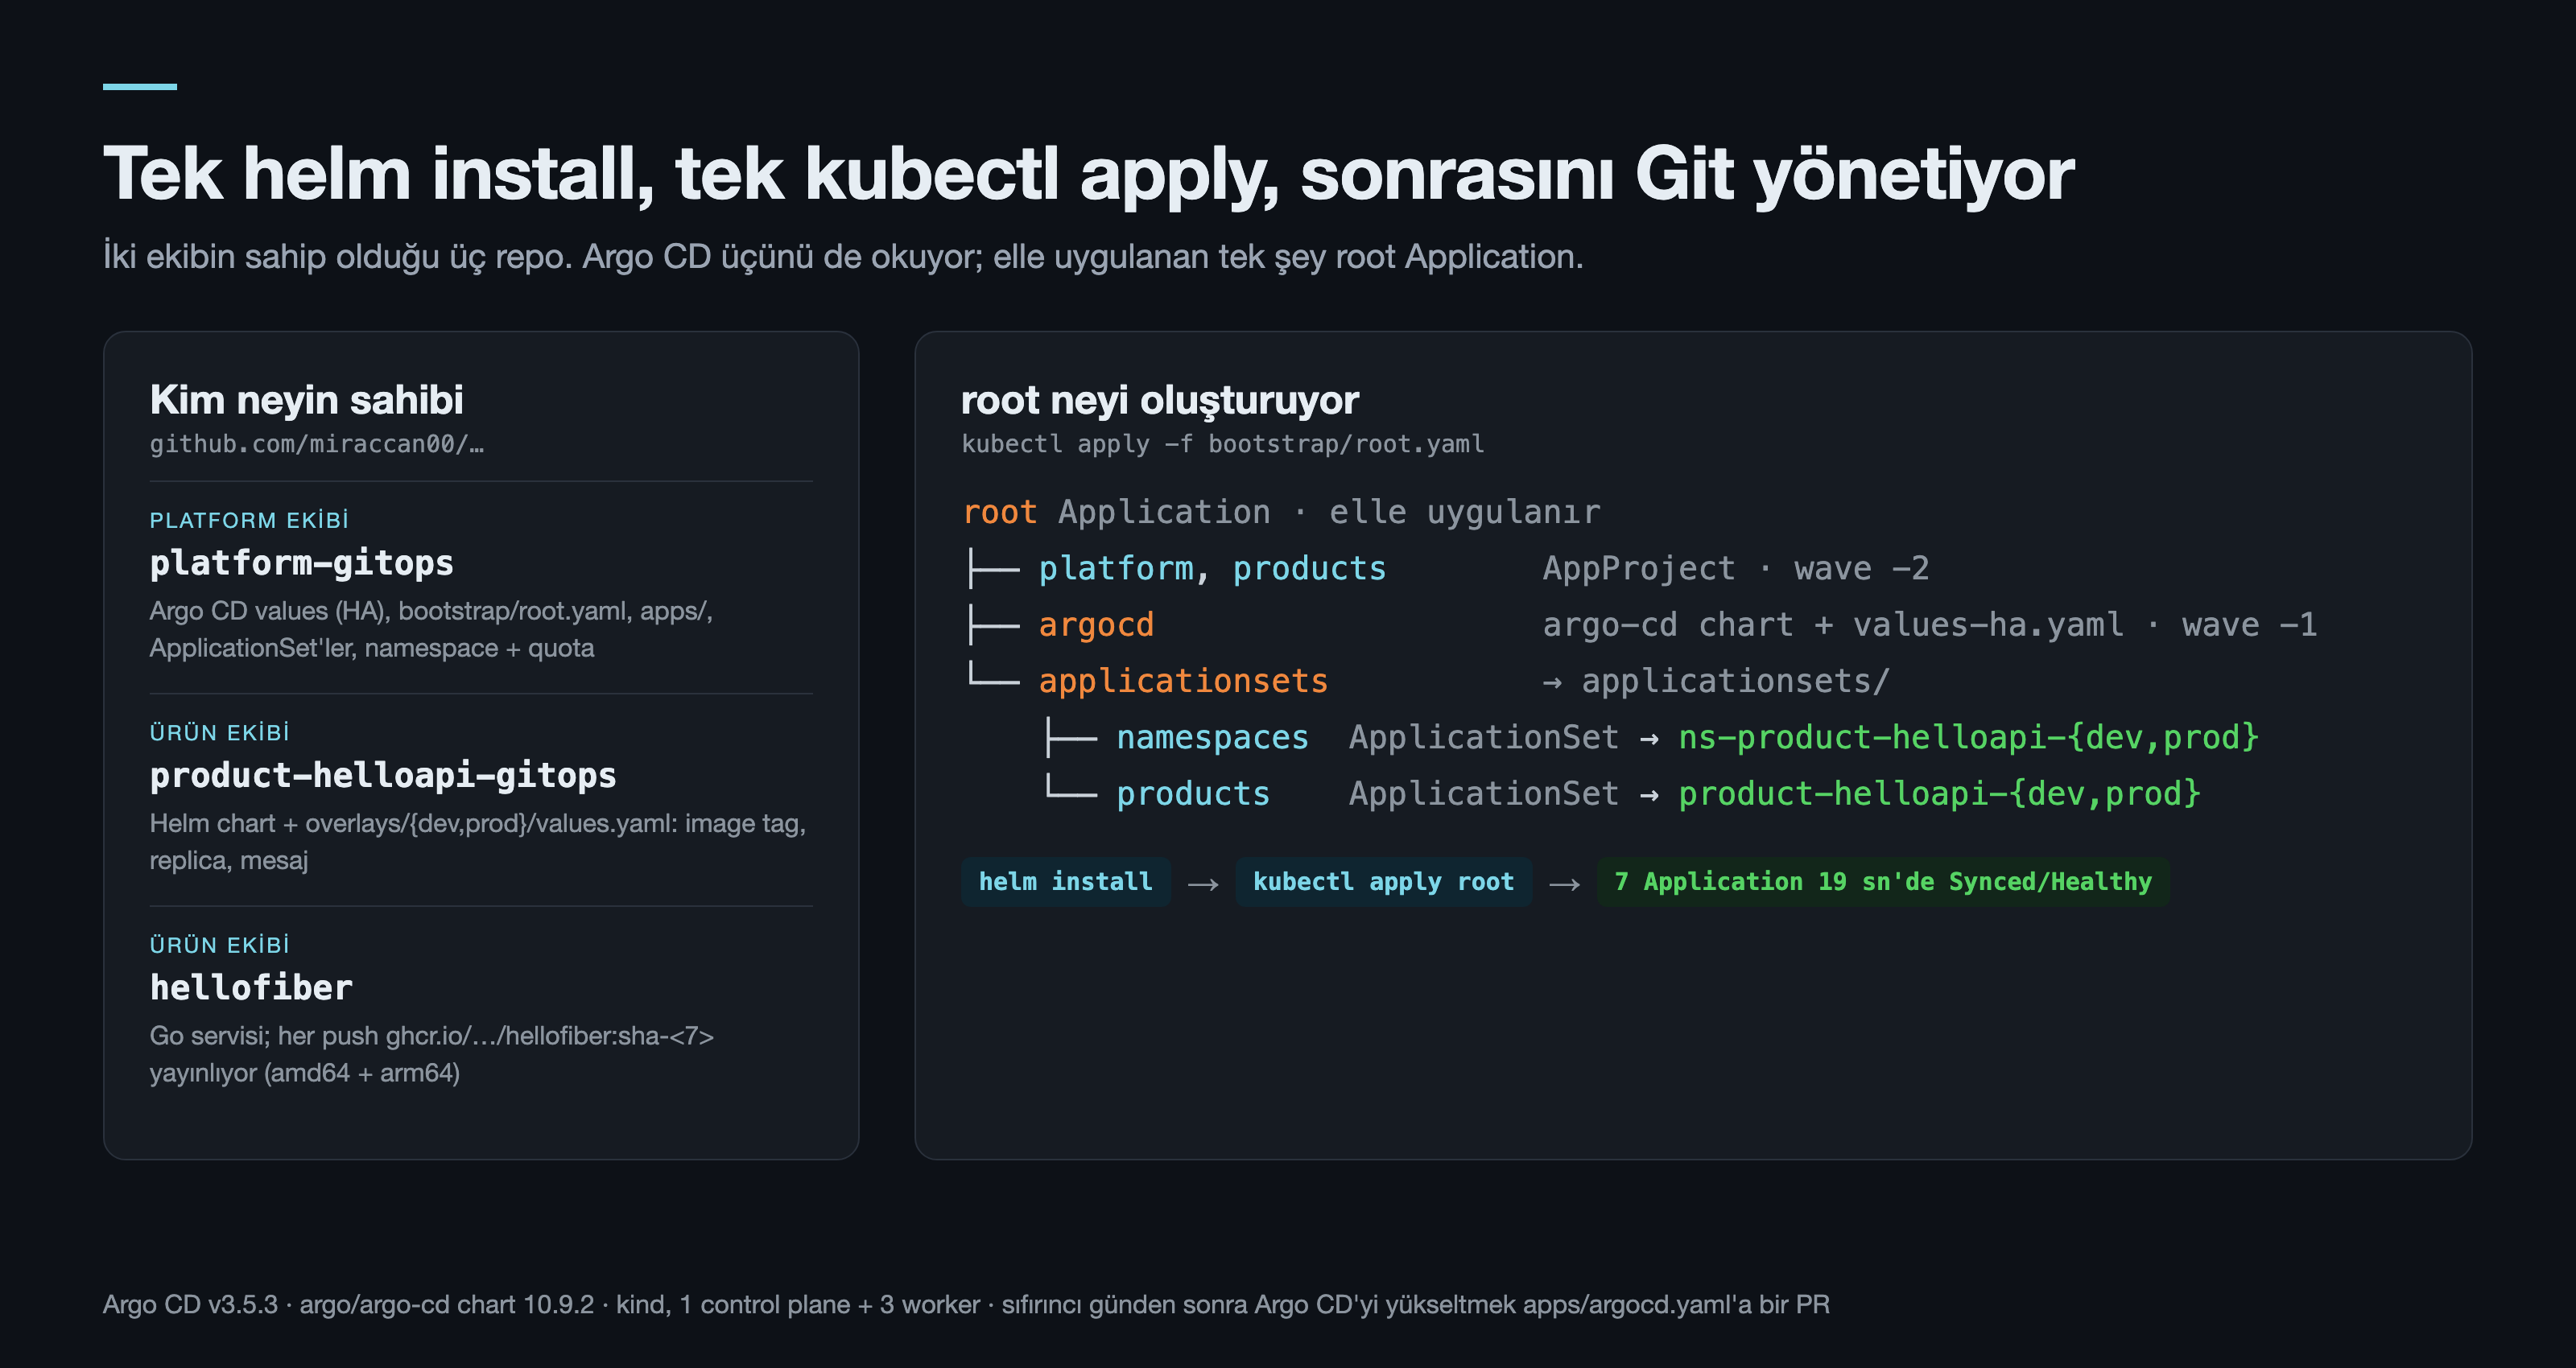
Lab argocd-ha-app-of-apps klasöründe. Argo CD'nin deploy ettiği şeyler, bir şirkette olacağı gibi üç ayrı public repoda duruyor: platform-gitops (platform ekibinin), product-helloapi-gitops (bir ürün ekibinin deploy config'i) ve hellofiber (o ekibin Go servisi).
Neye ihtiyacınız var
- 4 CPU / 8 GB Docker. Bu çalıştırmada: Apple Silicon üzerinde Colima 0.8, Docker 27. Her şey ayaktayken dört node yaklaşık 3 GB kullanıyor.
kind0.33,kubectl,helm3.15+. macOS'ta:brew install kind kubectl helm.- Bu çalıştırmadaki sürümler: argo/argo-cd chart 10.9.2 (Argo CD v3.5.3, Redis 8.6.4),
kindest/node:v1.35.0. - Temel Argo CD:
Applicationnedir, sync ve health ne demek. Bu, Production'da GitOps serisinin ilk yazısı; blogdaki önceki yazılardan hiçbiri gerekmiyor.
Neden bu şekilde
ha/install.yaml değil, Helm chart. Argo CD düz HA manifest'leri de yayınlıyor ve ben yıllarca onları kullandım. Chart'ın tek bir üstünlüğü var: values dosyası, sonrasında Argo CD'nin kendisiyle ilgili yönettiği şeyin ta kendisi oluyor. Düz manifest'lerde upstream dosyanın üstüne ConfigMap patch'lemeye başlıyorsunuz ve bu çok belirli bir şekilde bozuluyor (Ne ters gitti bölümüne bakın).
Tek dev Application değil, app-of-apps. Ekip başına tek Application, bozuk bir manifest o ekibin bütün servislerini bloklayana ve her sync dakikalar sürene kadar daha basit görünüyordu. Burada elle uygulanan tek şey root. Bir dizini gösteriyor ve o dizindeki her şey kendi başına bir Application: Argo CD'nin kendisi, AppProject'ler, ürün ve ortam başına birer Application üreten ApplicationSet'ler. Bozuk bir servis sadece kendi Application'ını bozuyor.
Tek repo değil, üç repo. Platform config'i, bir ürünün deploy config'i ve o ürünün kodu farklı hızlarda değişiyor ve farklı kişiler tarafından review ediliyor. Aşağıdaki ayrım bir şirkette kuracağım yapı; lab sadece private repolar yerine public GitHub repoları kullanıyor.
| Repo | Kim değiştiriyor | İçinde ne var |
|---|---|---|
platform-gitops |
platform ekibi | Argo CD values, bootstrap/root.yaml, apps/, ApplicationSet'ler, namespace + quota |
product-helloapi-gitops |
ürün ekibi | Helm chart, overlays/{dev,prod}/values.yaml (image tag, replica, mesaj) |
hellofiber |
ürün ekibi | Go kodu; CI, amd64 ve arm64 için ghcr.io/miraccan00/hellofiber:sha-<7> yayınlıyor |
Adım 1 — Üç worker ve tek bir helm install
Redis HA, üç pod'unu zorunlu anti-affinity ile üç ayrı node'a koyuyor. İki worker ile üçüncü Redis pod'u sonsuza kadar Pending kalır; o yüzden kind cluster'ında üç worker var:
# kind/cluster.yaml
kind: Cluster
apiVersion: kind.x-k8s.io/v1alpha4
name: argocd-ha
nodes:
  - role: control-plane
    image: kindest/node:v1.35.0
  - role: worker
    image: kindest/node:v1.35.0
  - role: worker
    image: kindest/node:v1.35.0
  - role: worker
    image: kindest/node:v1.35.0
Colima'da dört kind node'u varsayılan inotify limitlerini tüketiyor ve node container'ları açılışta ölüyor; scripts/colima-limits.sh limitleri yükseltiyor (Cluster API yazısındakiyle aynı script).
"HA"nın bileşen bileşen kararlaştırıldığı yer values dosyası. platform-gitops reposunda duruyor, çünkü Adım 2'de Argo CD onu tekrar okuyacak:
# platform-gitops/argocd/values-ha.yaml
redis-ha:
  enabled: true          # the chart's warning: needs 3 nodes (hard anti-affinity)

controller:
  replicas: 1            # no PDB: with one replica, minAvailable 1 would block every node drain

server:
  replicas: 2
  pdb:
    enabled: true
    minAvailable: 1

repoServer:
  replicas: 2
  pdb:
    enabled: true
    minAvailable: 1
  resources:
    requests:
      cpu: 100m
      memory: 256Mi
    limits:
      memory: 1Gi        # a mass sync renders many charts at once; this is the component that OOMs

applicationSet:
  replicas: 2
  pdb:
    enabled: true
    minAvailable: 1

dex:
  enabled: false         # SSO comes in the next post (OIDC); local admin for now

notifications:
  enabled: false

configs:
  params:
    server.insecure: "true"   # the lab reaches the UI through port-forward; TLS belongs on the gateway
    # Concurrent manifest generations per repo-server replica. 0 (default) = unlimited,
    # so a mass sync renders everything at once and memory spikes past the limit.
    reposerver.parallelism.limit: 5
  cm:
    # product-*-gitops overlays wrap the chart with kustomize `helmCharts:`.
    # Without this flag the repo-server refuses to render them:
    #   "must specify --enable-helm"
    kustomize.buildOptions: --enable-helm
Her satırın size kazandırdığı:
| Bileşen | Replica | Onun için HA ne demek |
|---|---|---|
Redis (redis-ha) |
3 Redis + 3 Sentinel, 3 HAProxy | Gerçek failover: Sentinel bir replica'yı master yapıyor, HAProxy trafiği yeni master'a yönlendiriyor |
| repo-server | 2 | Stateless, manifest render ediyor. İki replica yükü paylaşıyor; OOM'u durduran şey limit + paralellik sınırı |
| API server | 2 | Stateless UI/API. Olması iyi; kaybetmek sync'leri durdurmuyor |
| ApplicationSet controller | 2 | Leader election: biri çalışıyor, biri bekliyor |
| application controller | 1 | Active-active değil. Fazla replica = cluster'lar arasında sharding; tek hedef cluster varken ikinci replica sadece bekler |
Akılda tutulacak satır sonuncusu. Adım 5'te geri geliyor.
make argocd
# helm install argocd argo/argo-cd --version 10.9.2 -n argocd --create-namespace \
#   -f https://raw.githubusercontent.com/miraccan00/platform-gitops/blog-04/argocd/values-ha.yaml --wait --timeout 10m
helm install --wait 343 saniye sürdü. Çoğu Redis: StatefulSet üç pod'unu sırayla başlatıyor ve her biri Sentinel'in kendisini görmesini bekliyor. On üç pod, üç worker'a dağılmış (sütunlar kısaltıldı):
NAME                                               READY   STATUS    NODE
argocd-redis-ha-haproxy-647d9bfdf8-qlqcs           1/1     Running   argocd-ha-worker
argocd-server-8646bcb568-lqw9s                     1/1     Running   argocd-ha-worker
argocd-repo-server-566fc4b49f-q4gk4                1/1     Running   argocd-ha-worker
argocd-redis-ha-server-1                           3/3     Running   argocd-ha-worker
argocd-repo-server-566fc4b49f-gw4t7                1/1     Running   argocd-ha-worker2
argocd-redis-ha-haproxy-647d9bfdf8-95wv6           1/1     Running   argocd-ha-worker2
argocd-redis-ha-server-2                           3/3     Running   argocd-ha-worker2
argocd-application-controller-0                    1/1     Running   argocd-ha-worker2
argocd-applicationset-controller-d864b8898-hvts8   1/1     Running   argocd-ha-worker2
argocd-redis-ha-haproxy-647d9bfdf8-s4xg9           1/1     Running   argocd-ha-worker3
argocd-redis-ha-server-0                           3/3     Running   argocd-ha-worker3
argocd-applicationset-controller-d864b8898-qkhnt   1/1     Running   argocd-ha-worker3
argocd-server-8646bcb568-cw8sr                     1/1     Running   argocd-ha-worker3
Bu yazıdaki son helm komutu bu.
UI'ı açın: bundan sonraki her adımı orada da izleyeceğiz
make ui
# http://localhost:8080  admin / <parola>
make ui önce admin parolasını yazıyor, sonra svc/argocd-server'a port-forward açıyor. Values'daki server.insecure: "true" yüzünden bu düz HTTP: tarayıcıya http://localhost:8080 yazın, kullanıcı adı admin. Port-forward tek bir argocd-server pod'una bağlanıyor ve Adım 5'te o pod ölebiliyor; make ui bu yüzden bir döngüde çalışıyor ve bağlantı koparsa kendini yeniden bağlıyor. make ui çalıştığı terminali meşgul ediyor: onu açık bırakın ve bundan sonraki bütün make komutlarını ikinci bir terminalde, aynı argocd-ha-app-of-apps/ klasöründe çalıştırın (Makefile KUBECONFIG'i ./.lab içinden kendisi ayarlıyor).
Yazıda geçen ekranların doğrudan adresleri, giriş yaptıktan sonra:
| Ekran | Adres |
|---|---|
| Bütün Application'lar | http://localhost:8080/applications |
| root ağacı | http://localhost:8080/applications/argocd/root |
| Argo CD'nin kendisi, Pods görünümü | http://localhost:8080/applications/argocd/argocd?view=pods |
| Ürün, prod | http://localhost:8080/applications/argocd/product-helloapi-prod |
| Ürün, dev | http://localhost:8080/applications/argocd/product-helloapi-dev |
| ApplicationSet'ler | http://localhost:8080/applicationsets |
Adreslerdeki ilk argocd, Application objelerinin durduğu namespace.
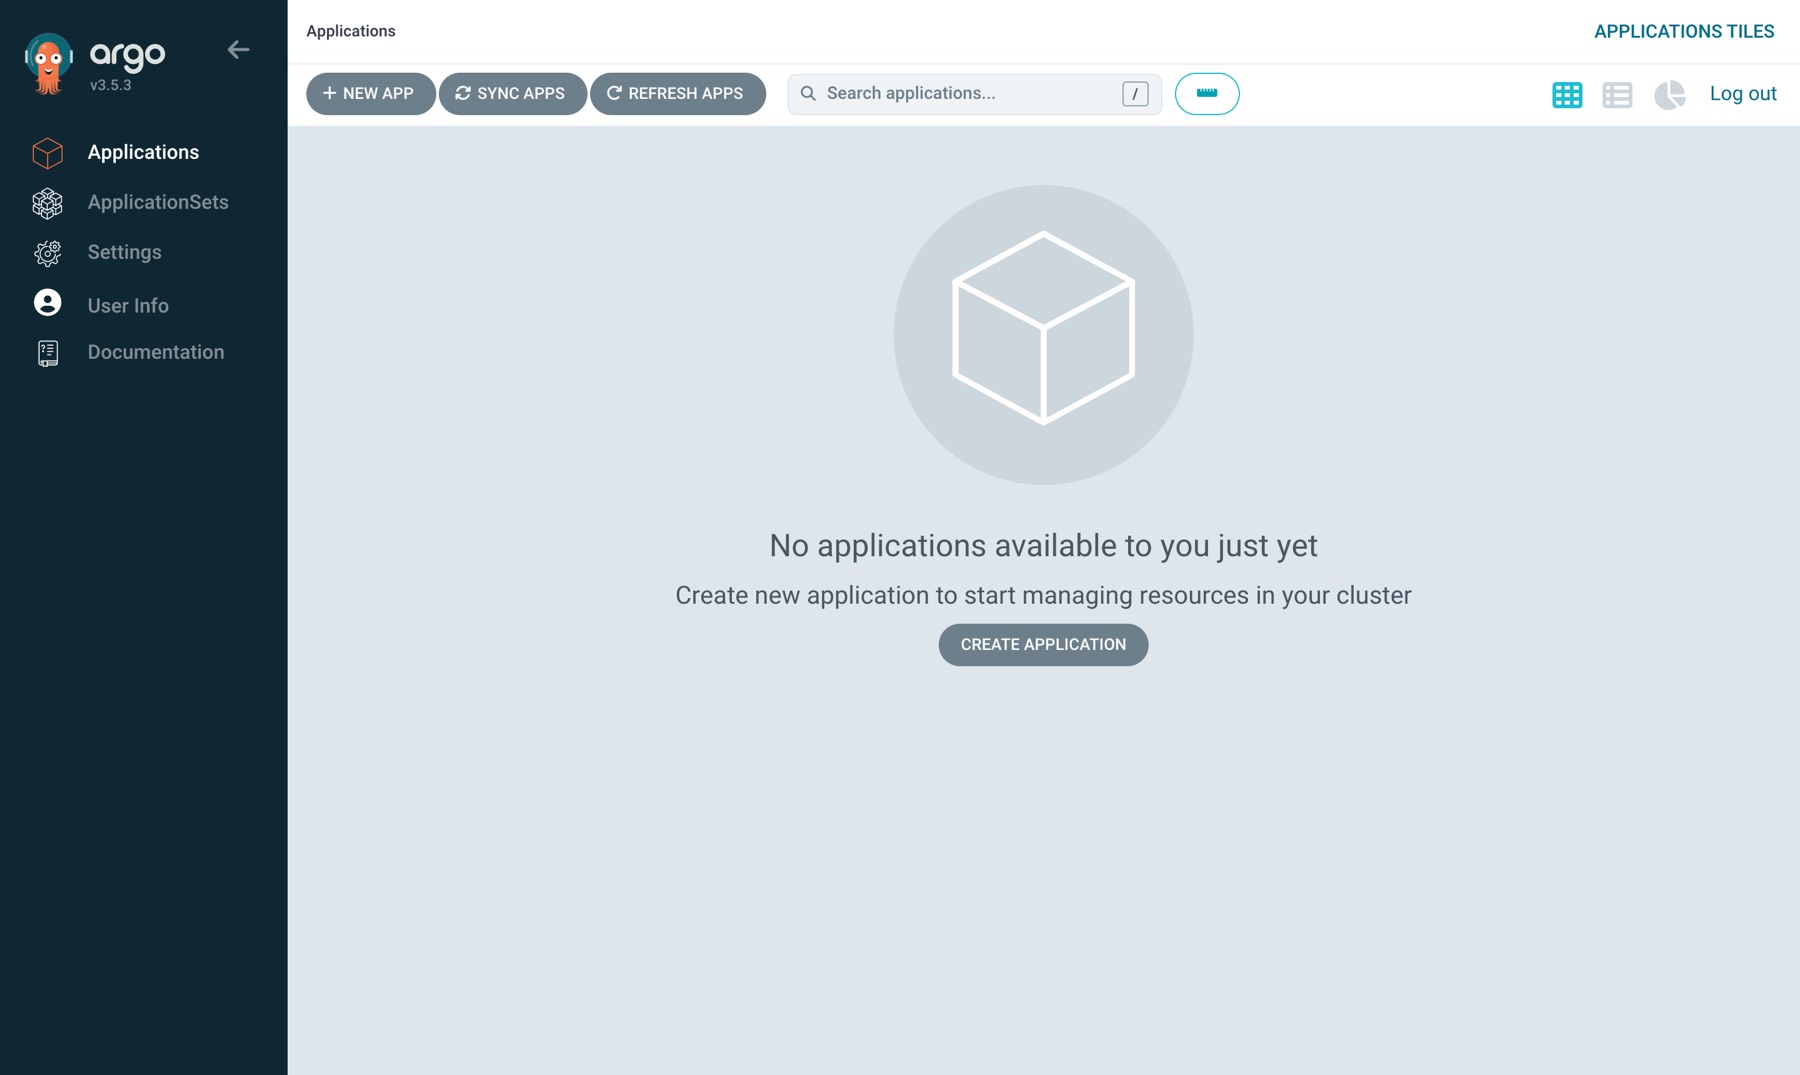
Bootstrap'tan önce Applications sayfası boş. Argo CD kurulu ve ayakta, ama henüz hiçbir şeyi yönetmiyor. Bu ekranı bir kez görmek önemli: birazdan tek bir kubectl apply bu sayfayı dolduracak.
Adım 2 — Tek bir kubectl apply, sonra Argo CD devralıyor
Elle uygulanan tek obje root Application:
# platform-gitops/bootstrap/root.yaml
apiVersion: argoproj.io/v1alpha1
kind: Application
metadata:
  name: root
  namespace: argocd
spec:
  project: default
  source:
    repoURL: https://github.com/miraccan00/platform-gitops.git
    targetRevision: blog-04
    path: apps
  destination:
    server: https://kubernetes.default.svc
    namespace: argocd
  syncPolicy:
    automated:
      # prune: a file deleted from apps/ removes that Application from the cluster.
      # Without it a deleted app keeps running and root shows OutOfSync forever.
      prune: true
      selfHeal: true
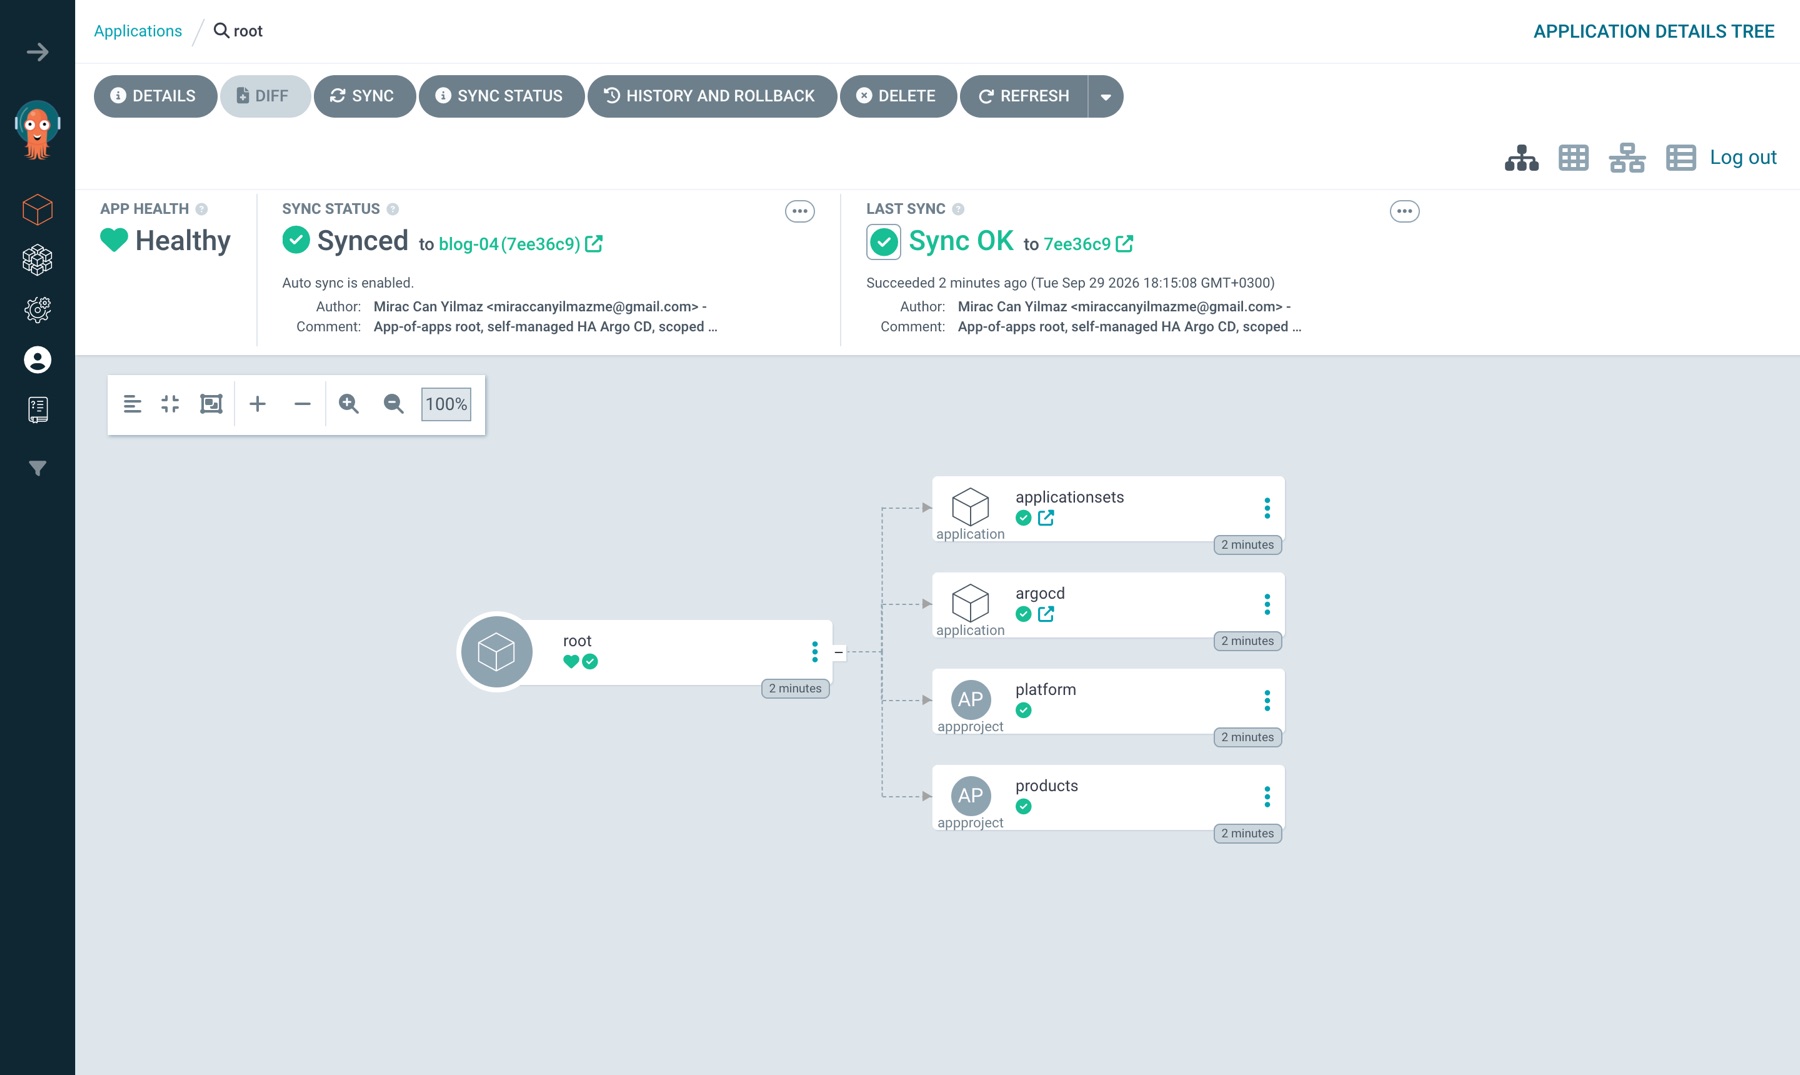
apps/ içinde üç dosya var ve ürettikleri ağaç platformun tamamı:
root (Application, elle uygulanır)
├── platform, products (AppProject, wave -2)
├── argocd (Application → argo-cd chart 10.9.2 + argocd/values-ha.yaml, wave -1)
└── applicationsets (Application → applicationsets/)
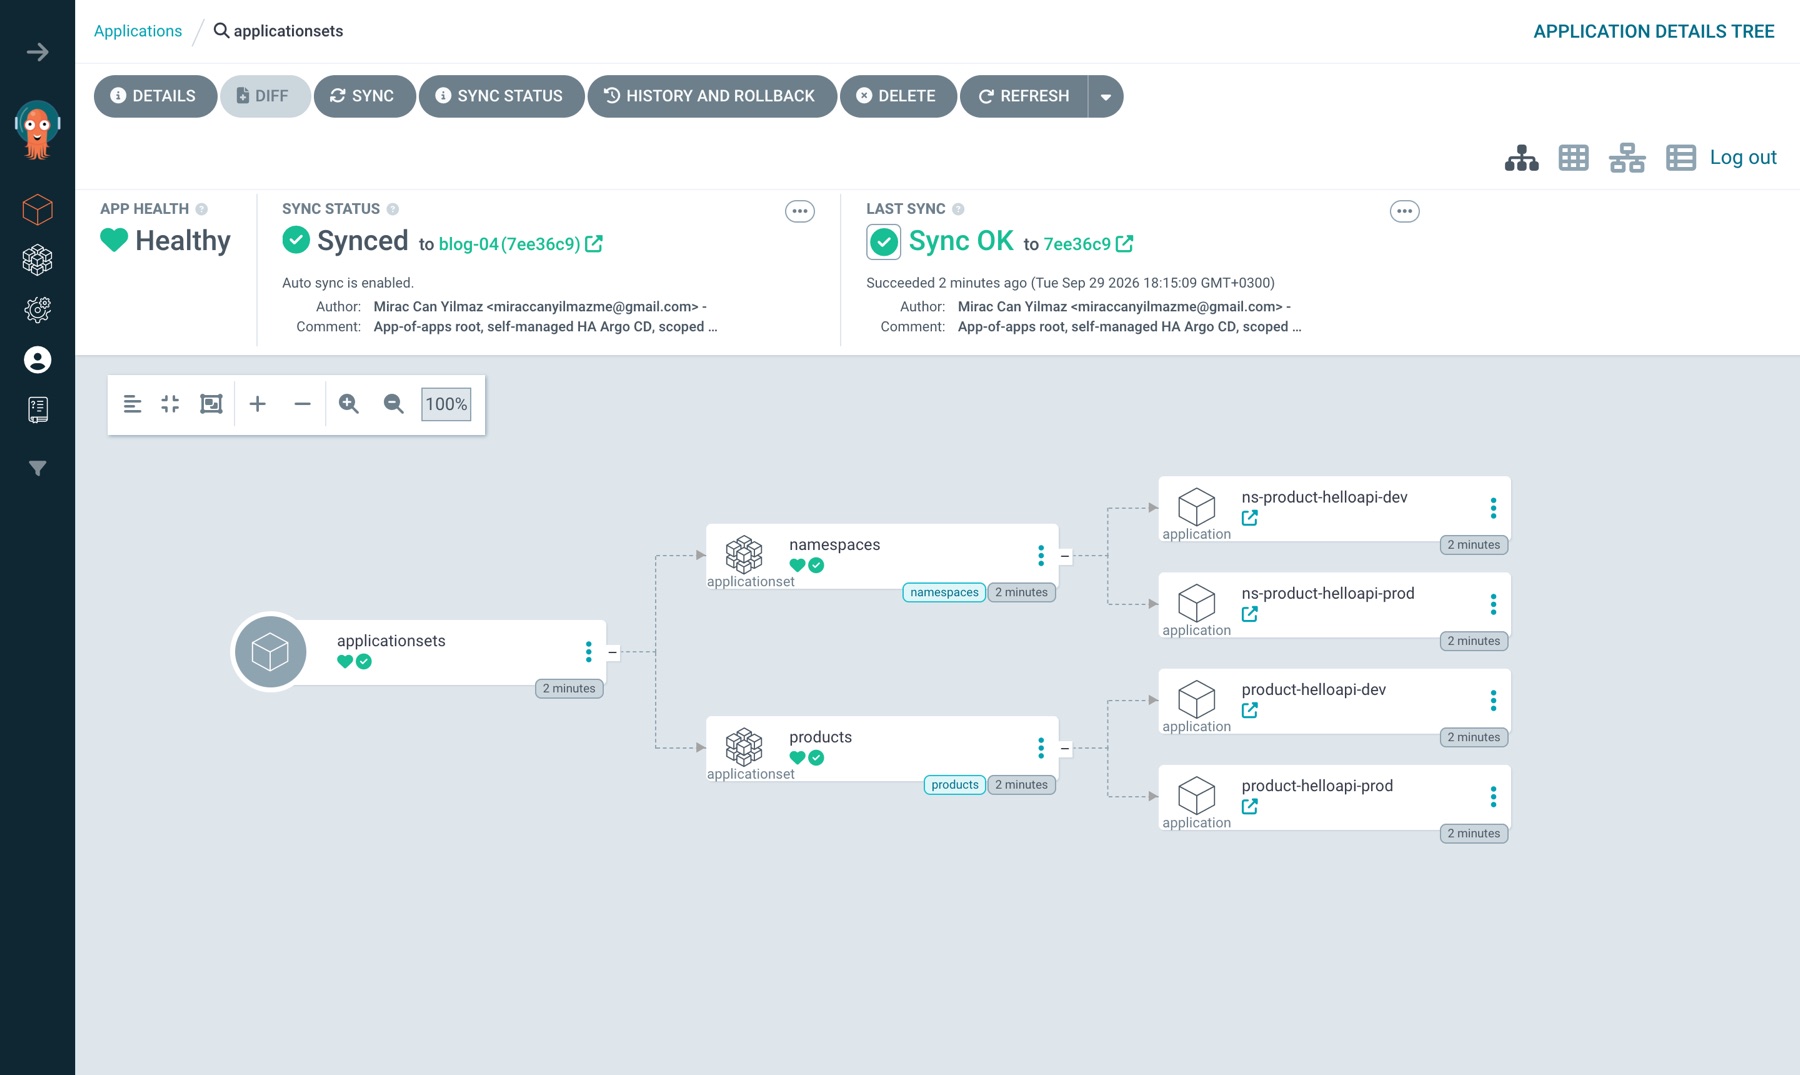
    ├── namespaces (ApplicationSet) → ns-product-helloapi-dev, ns-product-helloapi-prod
    └── products   (ApplicationSet) → product-helloapi-dev, product-helloapi-prod
İlginç olan argocd: Argo CD kendi kurulumunu, helm install'ın kullandığı aynı chart sürümü ve aynı values dosyasıyla yönetiyor.
# platform-gitops/apps/argocd.yaml (spec)
spec:
  project: platform
  sources:
    - repoURL: https://argoproj.github.io/argo-helm
      chart: argo-cd
      targetRevision: 10.9.2
      helm:
        releaseName: argocd          # must match `helm install argocd ...`, or every object name changes
        valueFiles:
          - $values/argocd/values-ha.yaml
    - repoURL: https://github.com/miraccan00/platform-gitops.git
      targetRevision: blog-04
      ref: values
  destination:
    server: https://kubernetes.default.svc
    namespace: argocd
  syncPolicy:
    automated:
      # prune false, on purpose: a bad commit that drops a ConfigMap or the redis
      # StatefulSet from the render would make Argo CD delete the parts it runs on,
      # and it could not sync itself back. selfHeal still reverts drift.
      prune: false
      selfHeal: true
    syncOptions:
      - ServerSideApply=true
İki source: chart Helm reposundan, values dosyası Git'ten ($values ikinci source'u gösteriyor). Bundan sonra Argo CD'yi yükseltmek, targetRevision'ı değiştiren tek satırlık bir PR.
make bootstrap
# kubectl apply -f https://raw.githubusercontent.com/miraccan00/platform-gitops/blog-04/bootstrap/root.yaml
NAME                       SYNC STATUS   HEALTH STATUS
applicationsets            Synced        Healthy
argocd                     Synced        Healthy
ns-product-helloapi-dev    Synced        Healthy
ns-product-helloapi-prod   Synced        Healthy
product-helloapi-dev       Synced        Healthy
product-helloapi-prod      Synced        Healthy
root                       Synced        Healthy
all 7 Synced/Healthy in 19s
kubectl apply'dan yedi yeşil Application'a on dokuz saniye.
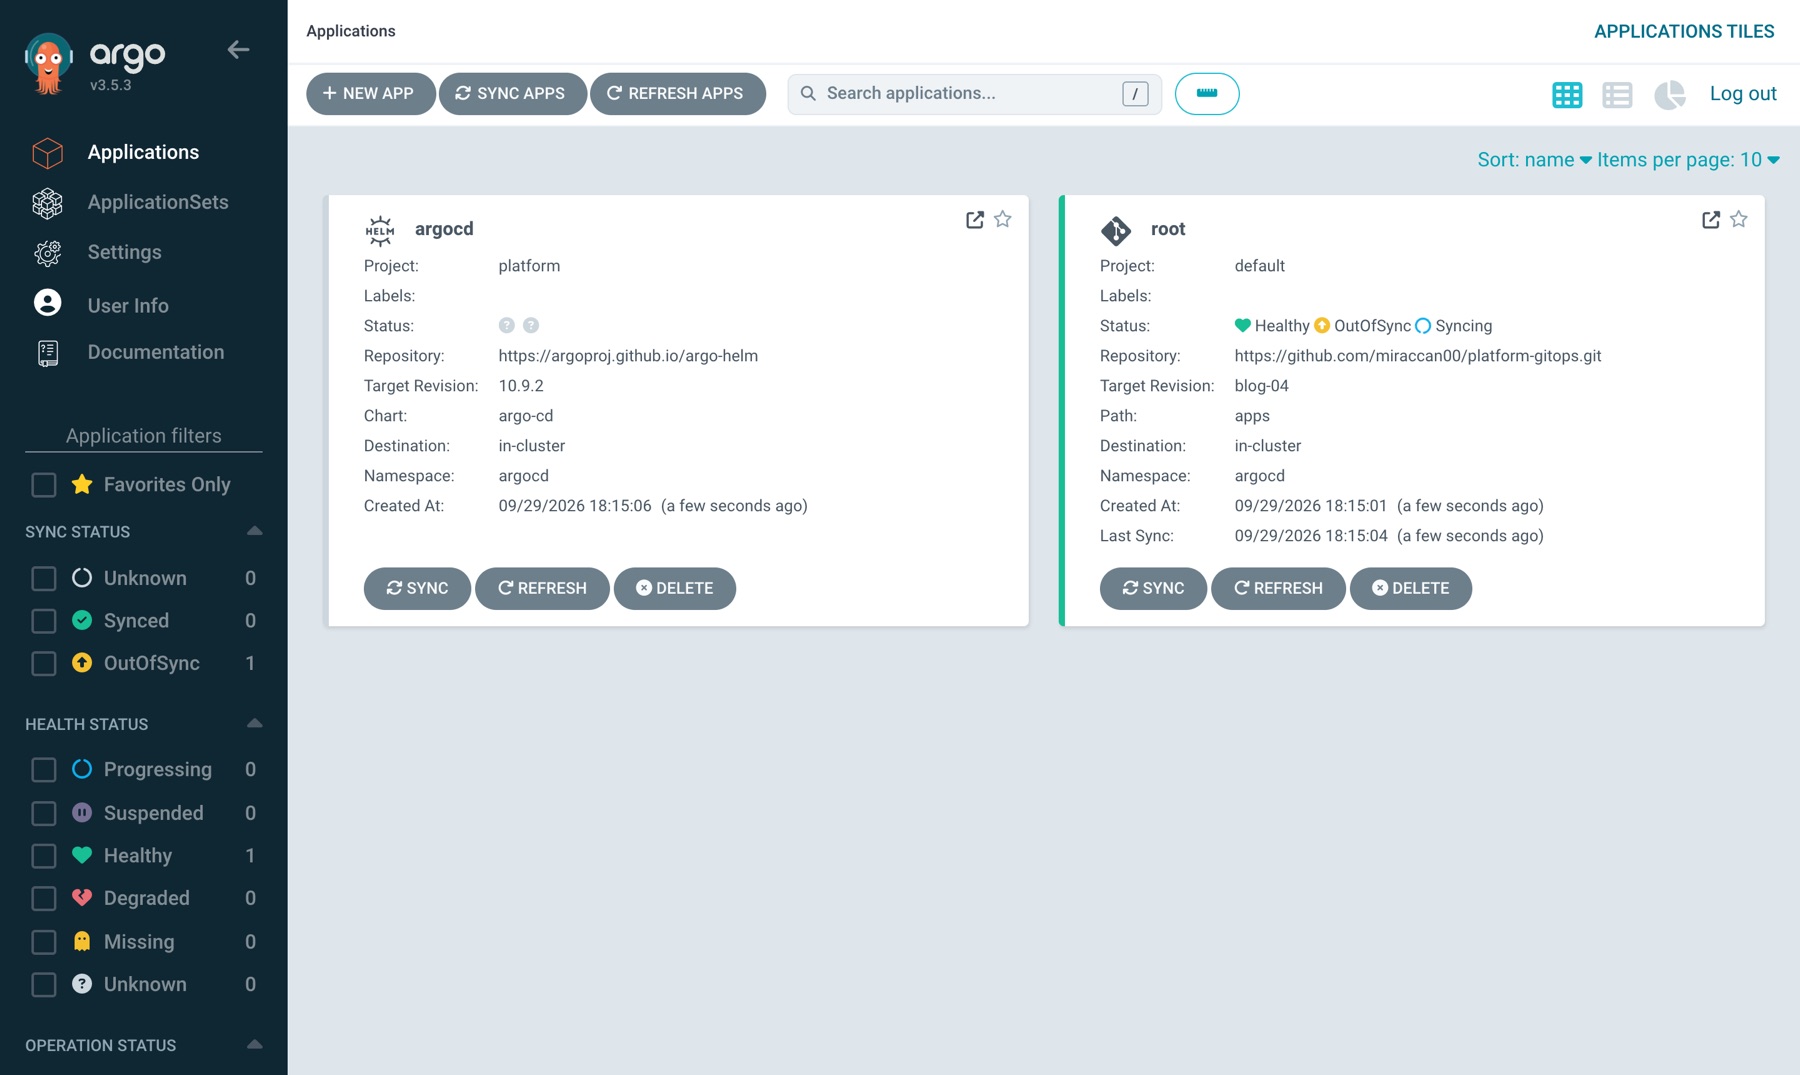
UI'da: make bootstrap'ı UI açıkken çalıştırın. Bu ekran apply'dan beş saniye sonra: root Syncing, argocd Application'ı yeni oluşmuş, applicationsets henüz yok. argocd wave -1'de, applicationsets wave 0'da; root'un sync'i wave sırasını izliyor.
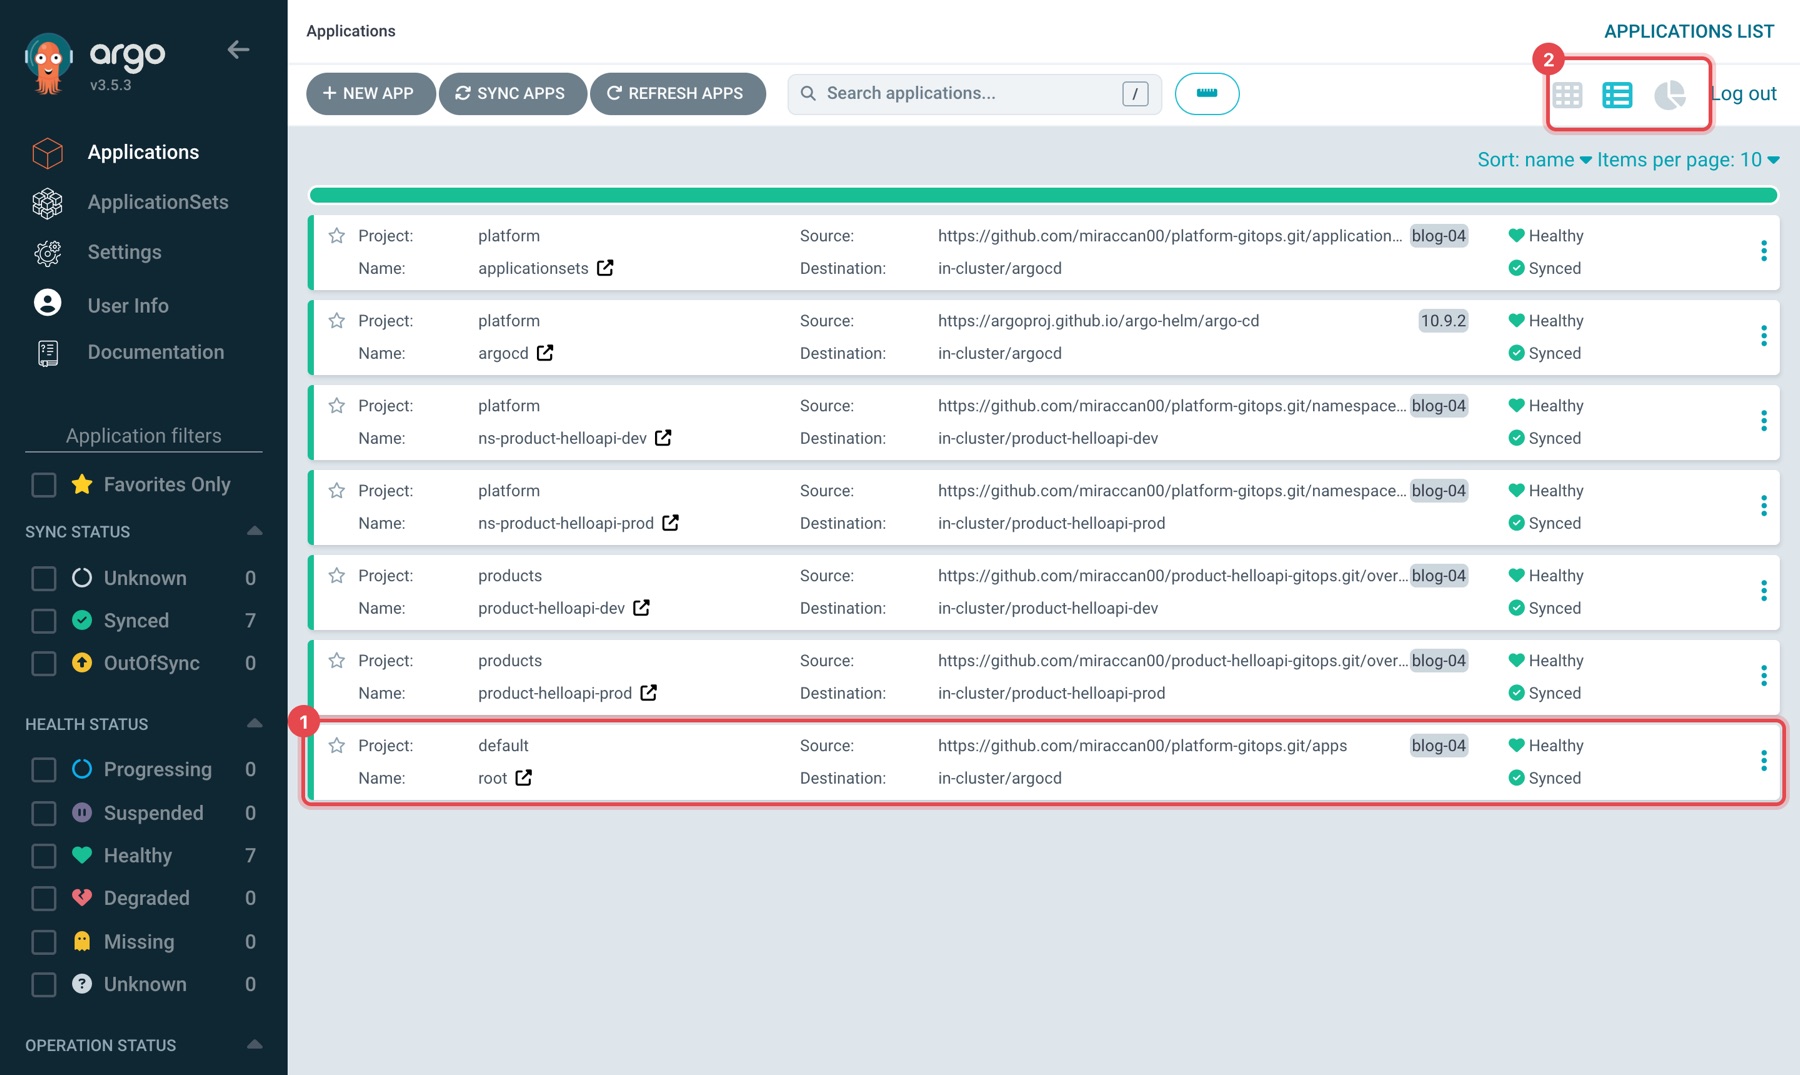
Yirmi saniye sonra sağ üstteki liste ikonuyla (2) liste görünümüne geçin: yedi Application yeşil. En alttaki root satırına (1) tıklayın.
root'un ağacı apps/ dizininin kendisi: iki AppProject ve iki Application. Kartlardaki ↗ ikonu o Application'ın kendi sayfasını açıyor.
applicationsets kartındaki ↗ ile bir kat aşağı inin. Yukarıdaki metin ağacının ikinci yarısı bu ekran: iki ApplicationSet ve ürettikleri dört Application.
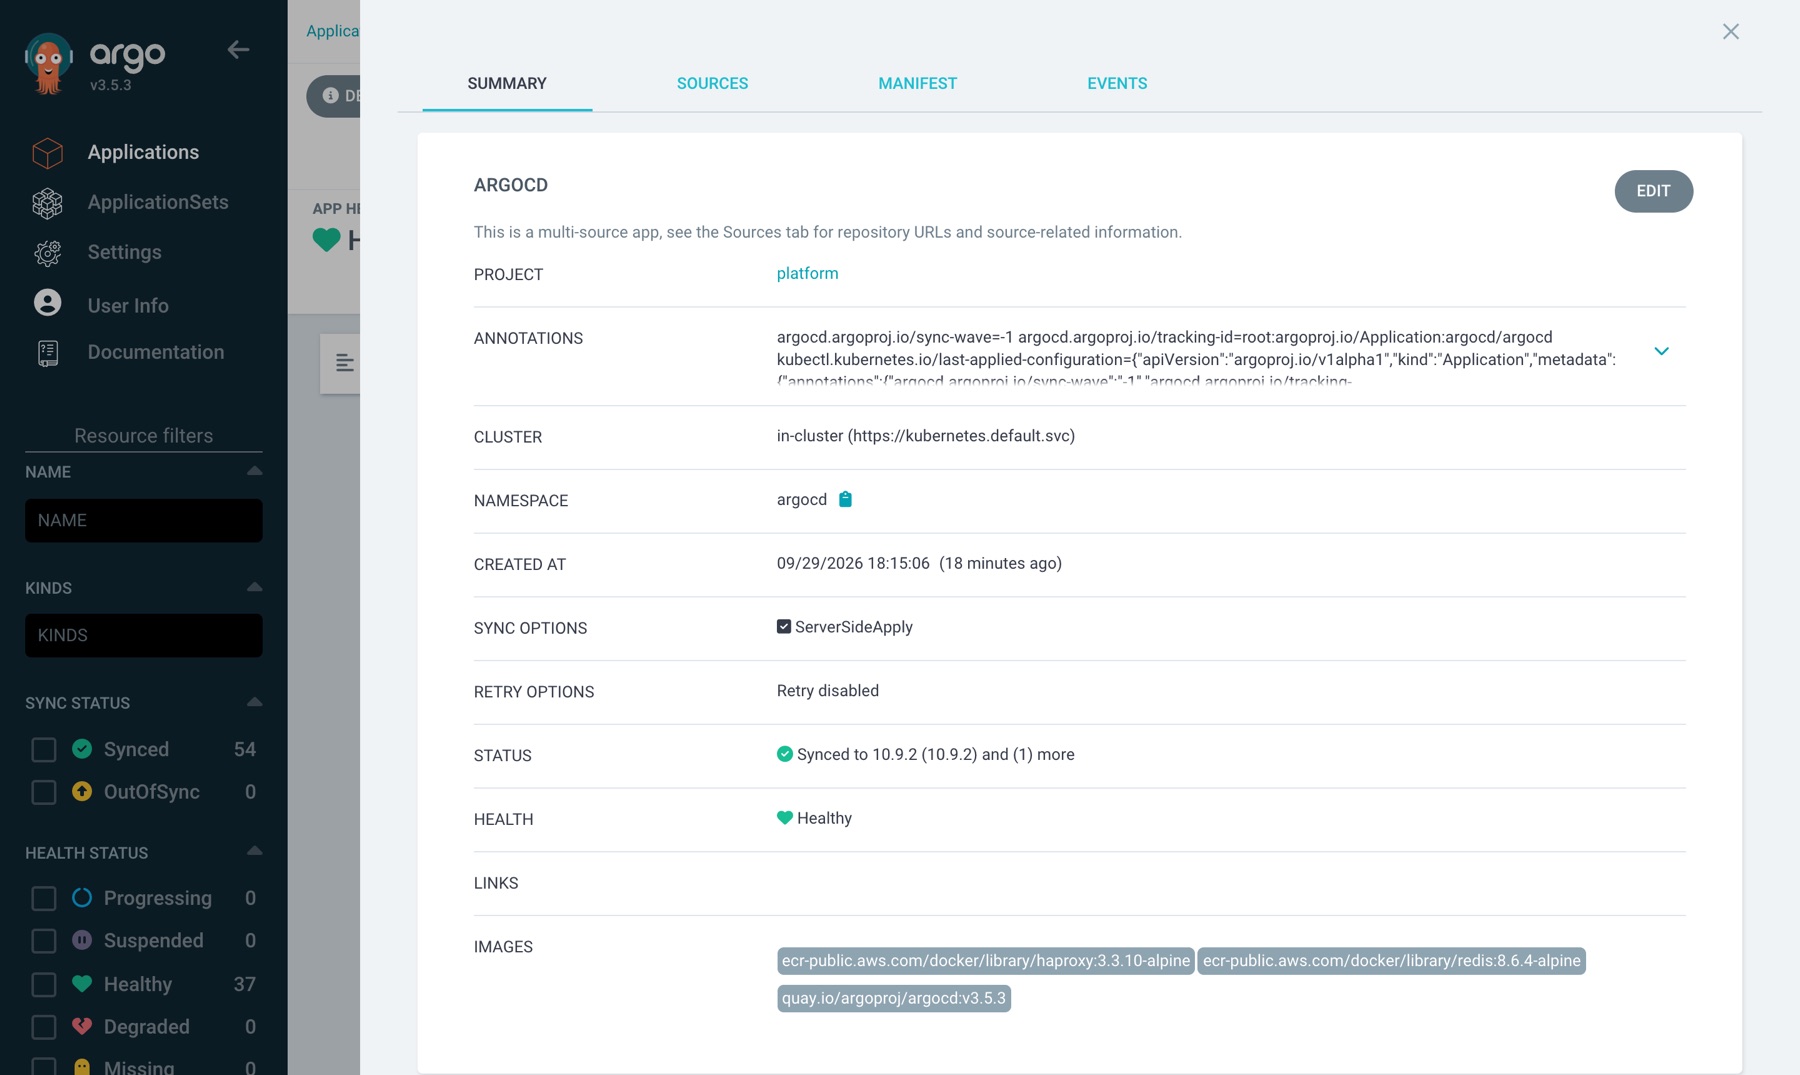
argocd Application'ında DETAILS'e tıklayın. Summary "This is a multi-source app" diyor, annotation'larda sync-wave=-1 duruyor, IMAGES satırında da chart'ın getirdiği üç image var (argocd v3.5.3, redis 8.6.4, haproxy). SOURCES sekmesi chart'ı ve $values referansını ayrı ayrı gösteriyor.
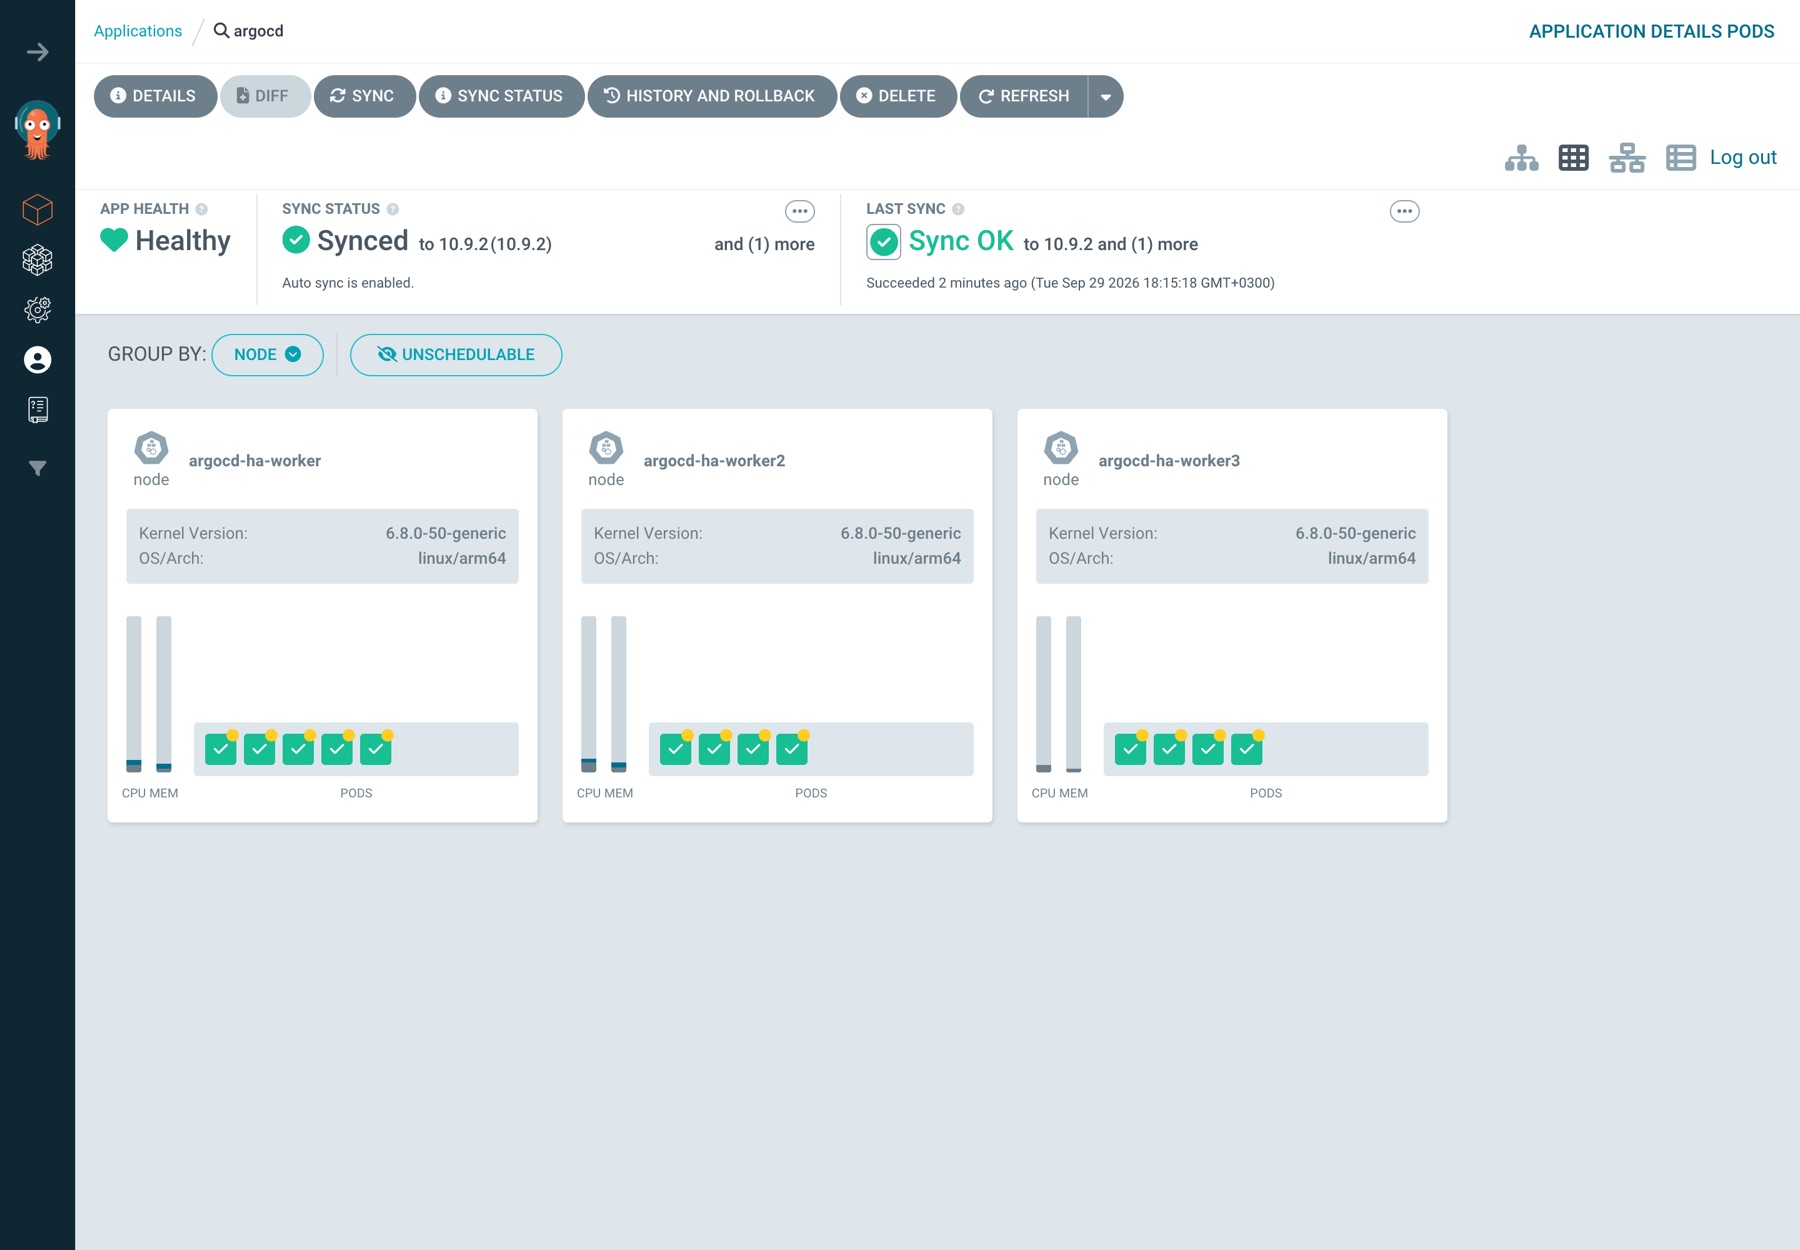
Paneli kapatın ve sağ üstteki ikinci ikona, Pods görünümüne geçin; GROUP BY NODE kalsın. HA'nın gerçekte neye benzediğini gösteren ekran bu: on üç pod, üç worker'a dağılmış. Adım 5'te bu ekrana geri döneceğiz.
Güvenmediğim için kontrol ettiğim iki şey:
- Kendi kurulumunu devralmak hiçbir şeyi yeniden başlatmadı. Argo CD pod'larının hepsi
helm install'daki oluşturulma zamanını korudu. Render edilen objeler birebir aynıydı, server-side apply hiçbir pod template'ini değiştirmedi. - Helm hook'u tekrar çalıştı. Chart'ın
pre-installhook'u (argocd-redis-secret-init, Redis parolasını oluşturan bir Job) Argo CD'dePreSynchook'una dönüştü ve bir kez daha çalıştı. Idempotent olduğu için sorun değil; ama Argo CD'nin Helm çalıştırmadığını, chart'ı render edip Helm hook'larını kendi hook'larına eşlediğini de hatırlatıyor.
Bundan sonra helm upgrade çalıştırmayın. Objelerin sahibi Argo CD; sh.helm.release.v1.argocd.v1 release secret'ı sıfırıncı günün eskimiş bir kaydı olarak kalıyor.
Adım 3 — Ürün tarafı
platform-gitops içindeki products-appset.yaml ürün kaydı: ürün başına bir liste elemanı, ortamlarla çaprazlanıyor.
# platform-gitops/applicationsets/products-appset.yaml (generators + source)
  generators:
    - matrix:
        generators:
          - list:
              elements:
                - product: product-helloapi
                  productRepoURL: https://github.com/miraccan00/product-helloapi-gitops.git
          - list:
              elements:
                - env: dev
                - env: prod
  template:
    metadata:
      name: "{{ .product }}-{{ .env }}"
    spec:
      project: products
      source:
        repoURL: "{{ .productRepoURL }}"
        targetRevision: blog-04
        path: "overlays/{{ .env }}"
products AppProject'i sadece product-*-gitops adlı repoları ve product-* adlı namespace'leri kabul ediyor; cluster-scoped hiçbir şeye izin yok. Bir ürün ekibi yanlışlıkla argocd namespace'ine deploy edemez.
Ürün reposu kendi chart'ını kustomize ile sarıyor:
# product-helloapi-gitops/overlays/prod/kustomization.yaml
apiVersion: kustomize.config.k8s.io/v1beta1
kind: Kustomization

helmGlobals:
  chartHome: ../../

helmCharts:
  - name: chart
    releaseName: product-helloapi
    version: "0.2.0"
    valuesFile: values.yaml
Values dosyasında kustomize.buildOptions: --enable-helm bu yüzden var. O olmadan repo-server'daki kustomize (bu image'da v5.8.1) şu hatayla duruyor:
`: must specify --enable-helm
Servis iki ortamda da hellofiber'dan build edilen image ile cevap veriyor:
$ make hello
Hello from helloapi [DEV] (env=development, version=sha-d96497a)
Hello from helloapi [PROD] (env=production, version=sha-d96497a)
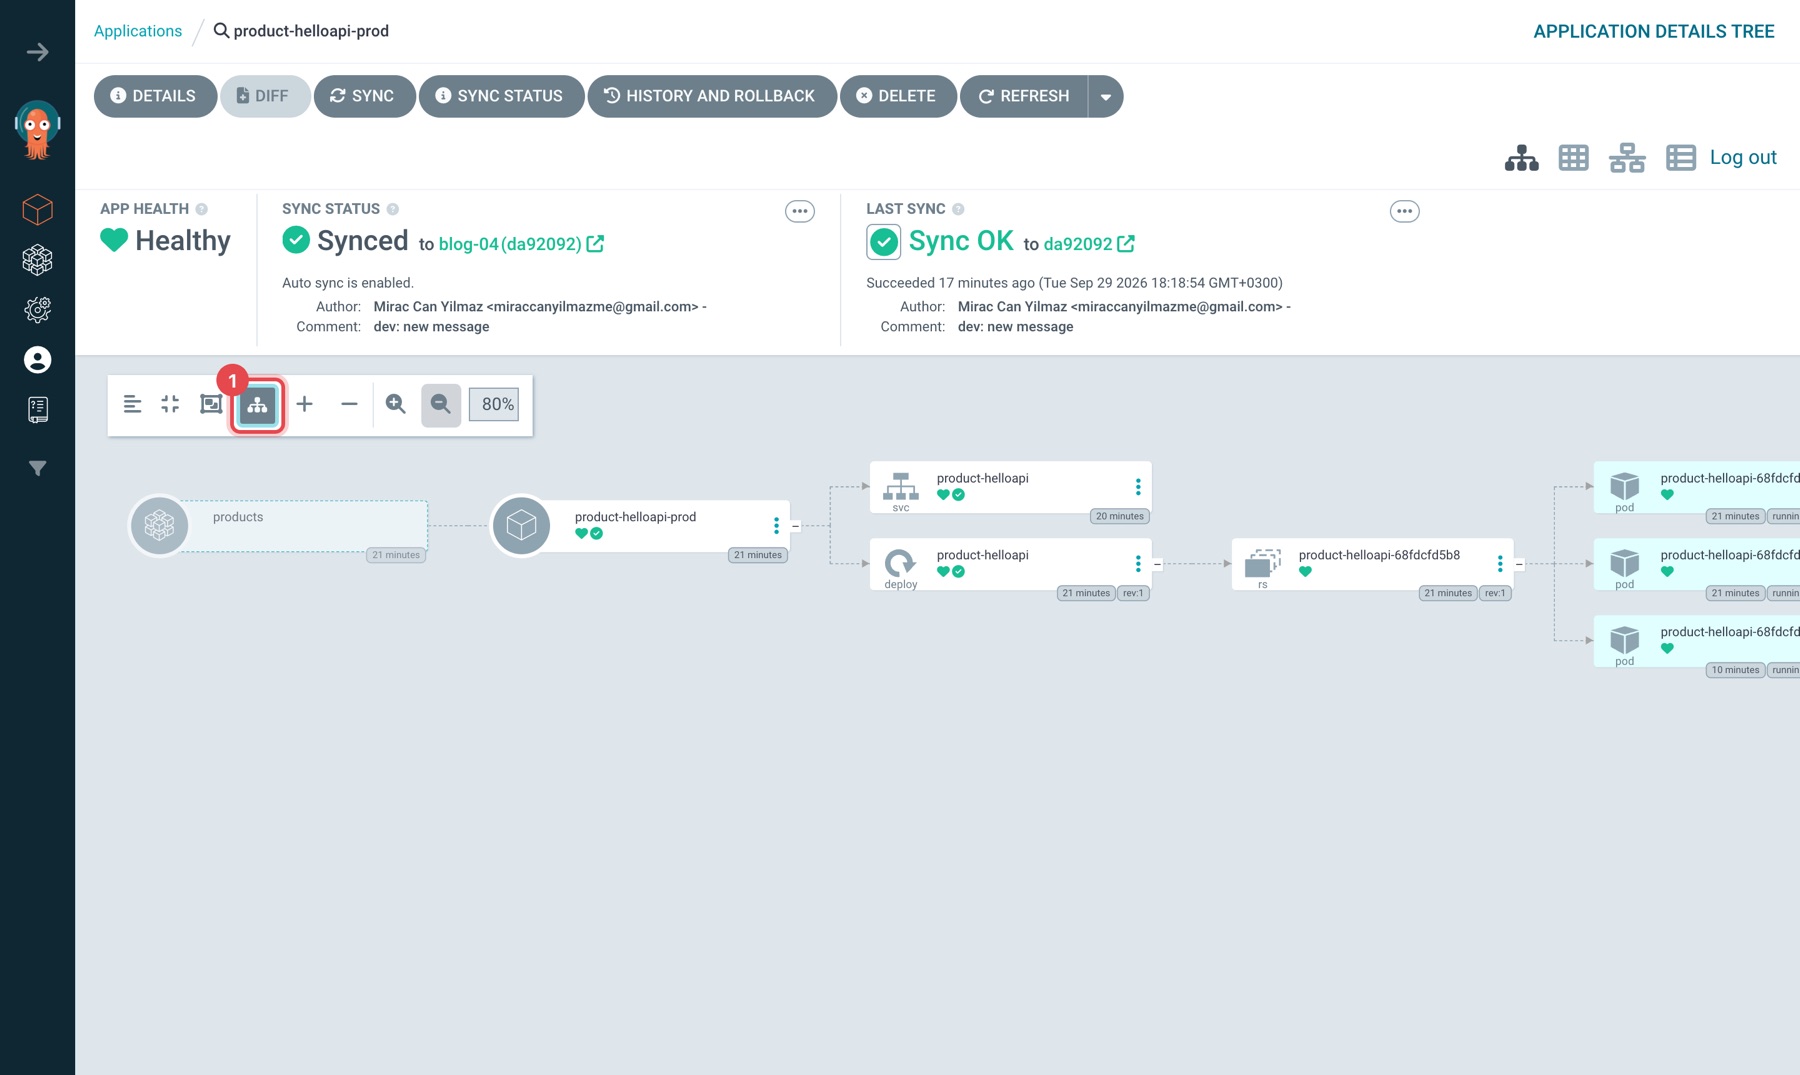
UI'da: Applications sayfasında product-helloapi-prod kartına tıklayın (ya da doğrudan http://localhost:8080/applications/argocd/product-helloapi-prod) ve ağaç araç çubuğundaki Show ApplicationSet parent node düğmesine (1) basın. En soldaki soluk düğüm bu Application'ı üreten products ApplicationSet'i; sağa doğru Service, Deployment → ReplicaSet → üç pod. Kartın altındaki products etiketi AppProject.
Adım 4 — Değişiklik çıkarmak bir commit
Prod 2 replica'dan 3'e çıkıyor. product-helloapi-gitops/overlays/prod/values.yaml içinde tek satır, commit, push. kubectl yok.
Webhook olmadan Argo CD Git'i her 120 saniyede, üstüne 60 saniyeye kadar jitter ekleyerek yokluyor (argocd-cm içinde timeout.reconciliation ve timeout.reconciliation.jitter). Bu çalıştırmada:
3/3 ready 91s after push (polling, no webhook)
Webhook, Argo CD'ye Git'e hemen bakmasını söylüyor. Lab bir GitHub webhook'u alamıyor, o yüzden scripts/ship.sh bir webhook'un yaptığı şeyi yapıyor, Application'a bir refresh annotation'ı koyuyor:
product-helloapi-dev: 943189e -> da92092, Synced/Healthy 4s after refresh
91 saniyeye karşı 4. Production'da webhook'u kurun; insanları "sadece bu seferlik" kubectl'e iten şey o 3 dakikalık en kötü durum. Ekiplere ilk gün verilen sayfa docs/how-to-ship-a-change.md: her değişiklik türü nerede duruyor, nasıl geri alınır (UI'daki düğmeyle değil, PR'ı revert ederek), her status ne anlama geliyor.
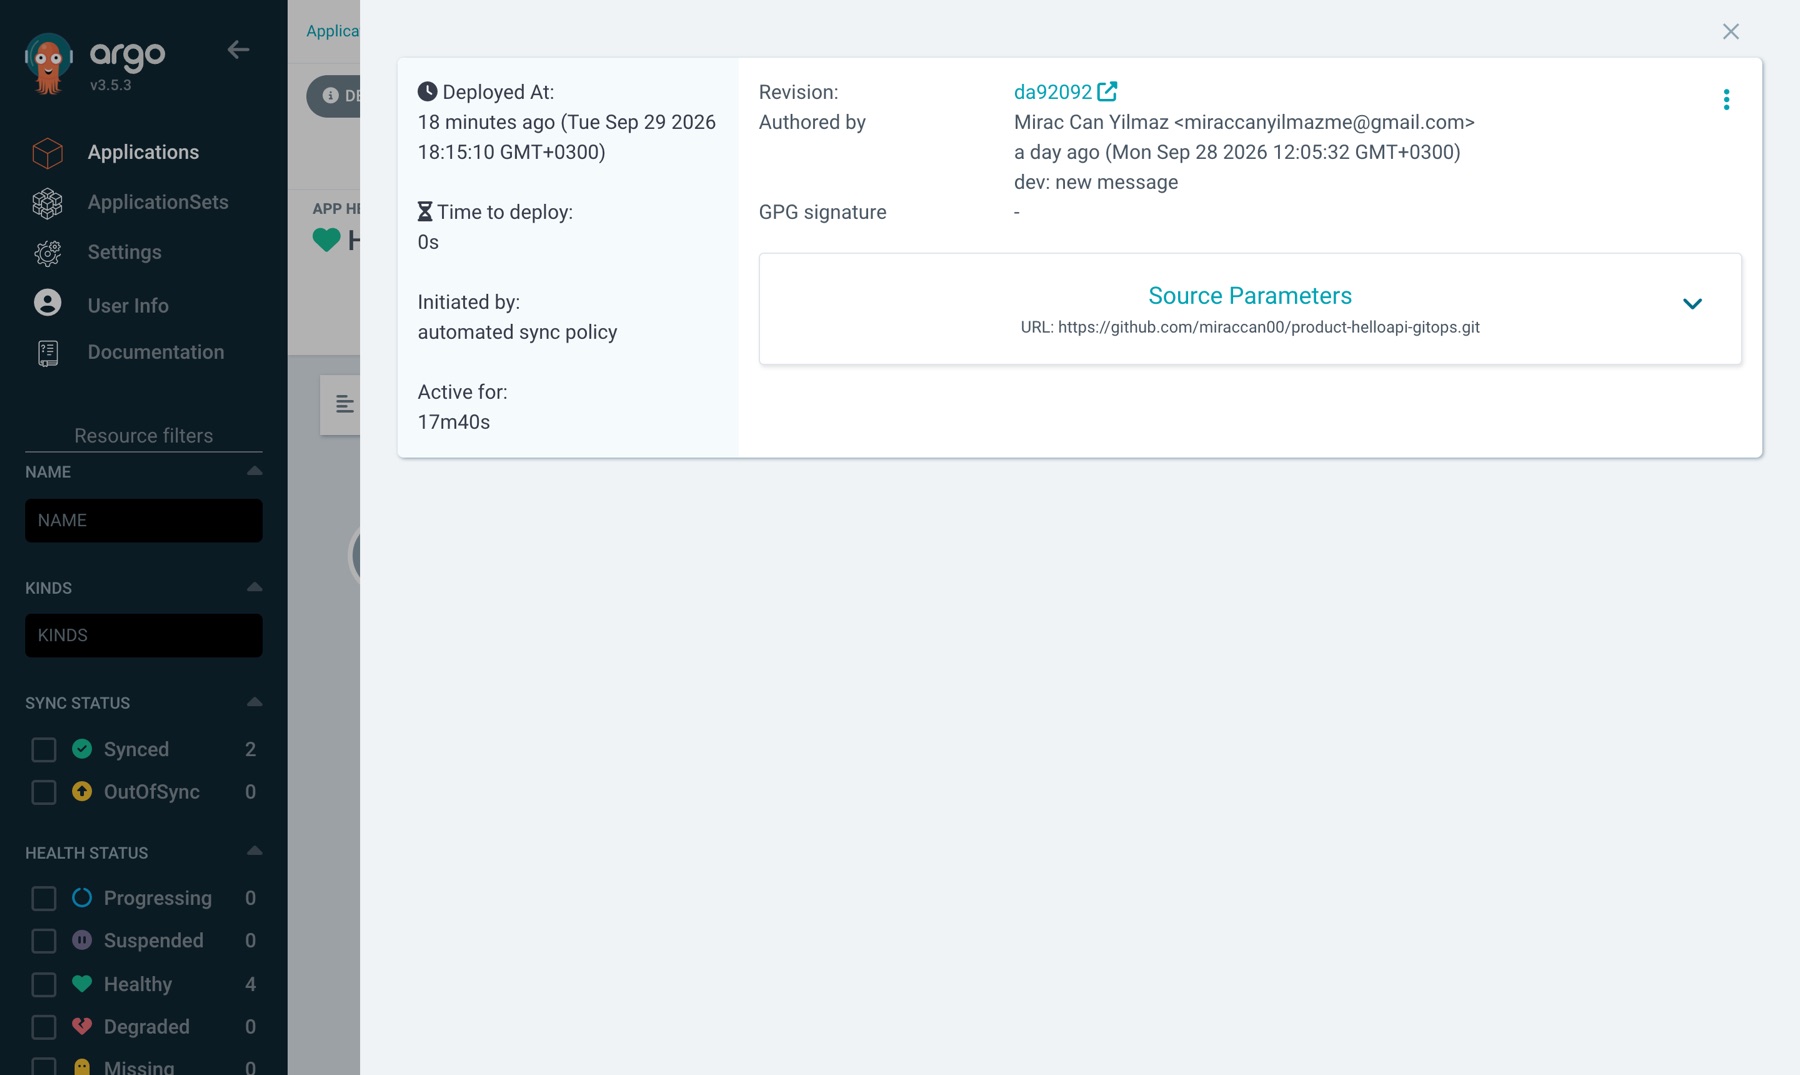
UI'da: product-helloapi-dev kartına tıklayın (http://localhost:8080/applications/argocd/product-helloapi-dev), üstteki HISTORY AND ROLLBACK düğmesine basın. Her deploy bir commit: hash, yazar, commit mesajı ve Initiated by: automated sync policy. Kimse düğmeye basmadı; Argo CD Git'te yeni commit'i görüp kendisi sync etti.
Bu repolara push yetkiniz yok, o yüzden bu adımı kendi lab'ınızda birebir tekrarlayamazsınız. Aynı döngüyü ters yönden görmek için Git yerine cluster'ı değiştirin, UI'da product-helloapi-prod açıkken:
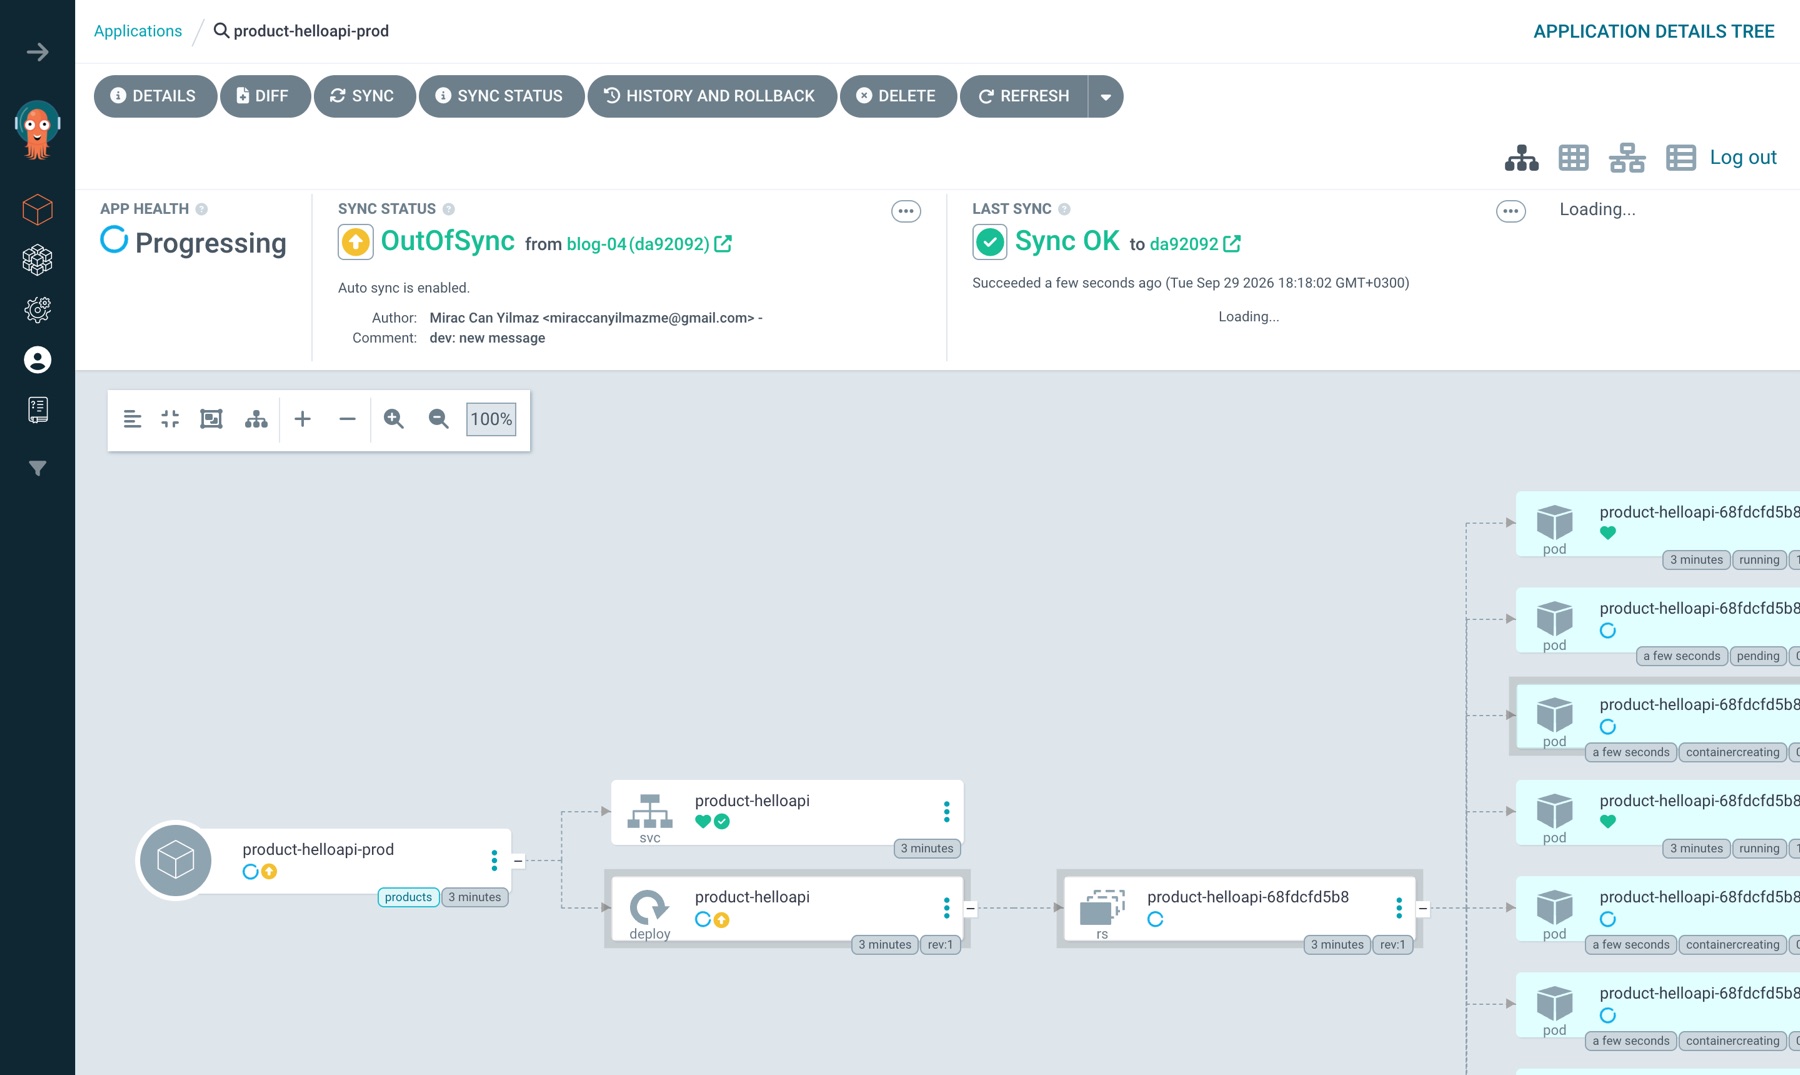
kubectl -n product-helloapi-prod scale deploy/product-helloapi --replicas=9
Bir saniye içinde Application OutOfSync ve Progressing oluyor, altı yeni pod oluşmaya başlıyor:
Bir saniye sonra selfHeal Deployment'ı Git'teki 3'e geri çekmiş, altı pod Terminating:
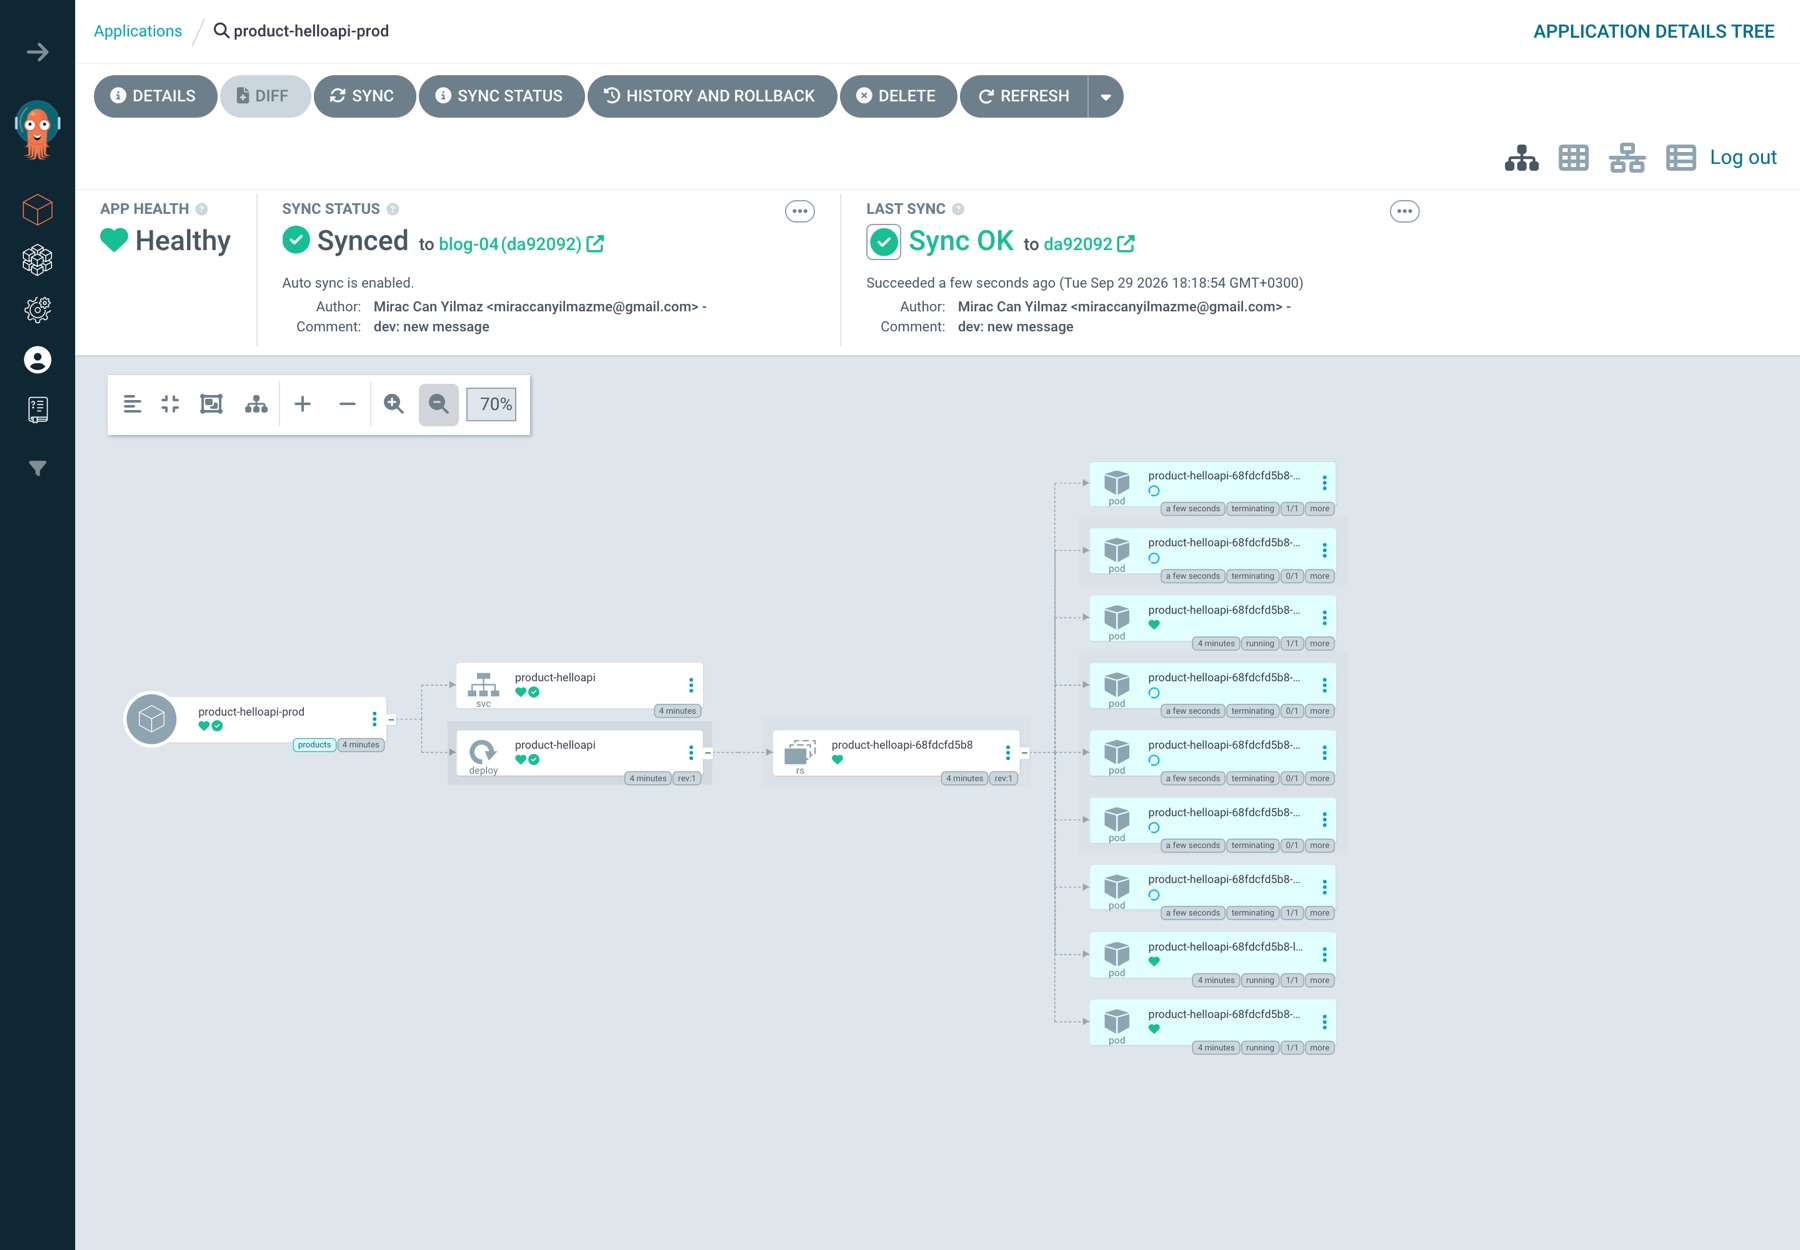
İkinci kez denerseniz daha uzun sürer; neden olduğu Ne ters gitti #2'de.
Adım 5 — Bozmak
Her arızadan sonra Argo CD'nin hâlâ çalıştığını kanıtlamak için scripts/probe.sh, product-helloapi-prod için hard refresh istiyor ve yeni bir reconciledAt bekliyor. Hard refresh üç hareketli parçanın üçüne de ihtiyaç duyuyor: karşılaştırmayı controller yapıyor, bir repo-server chart'ı cache'i atlayarak yeniden render ediyor ve sonuç Redis'ten geçiyor.
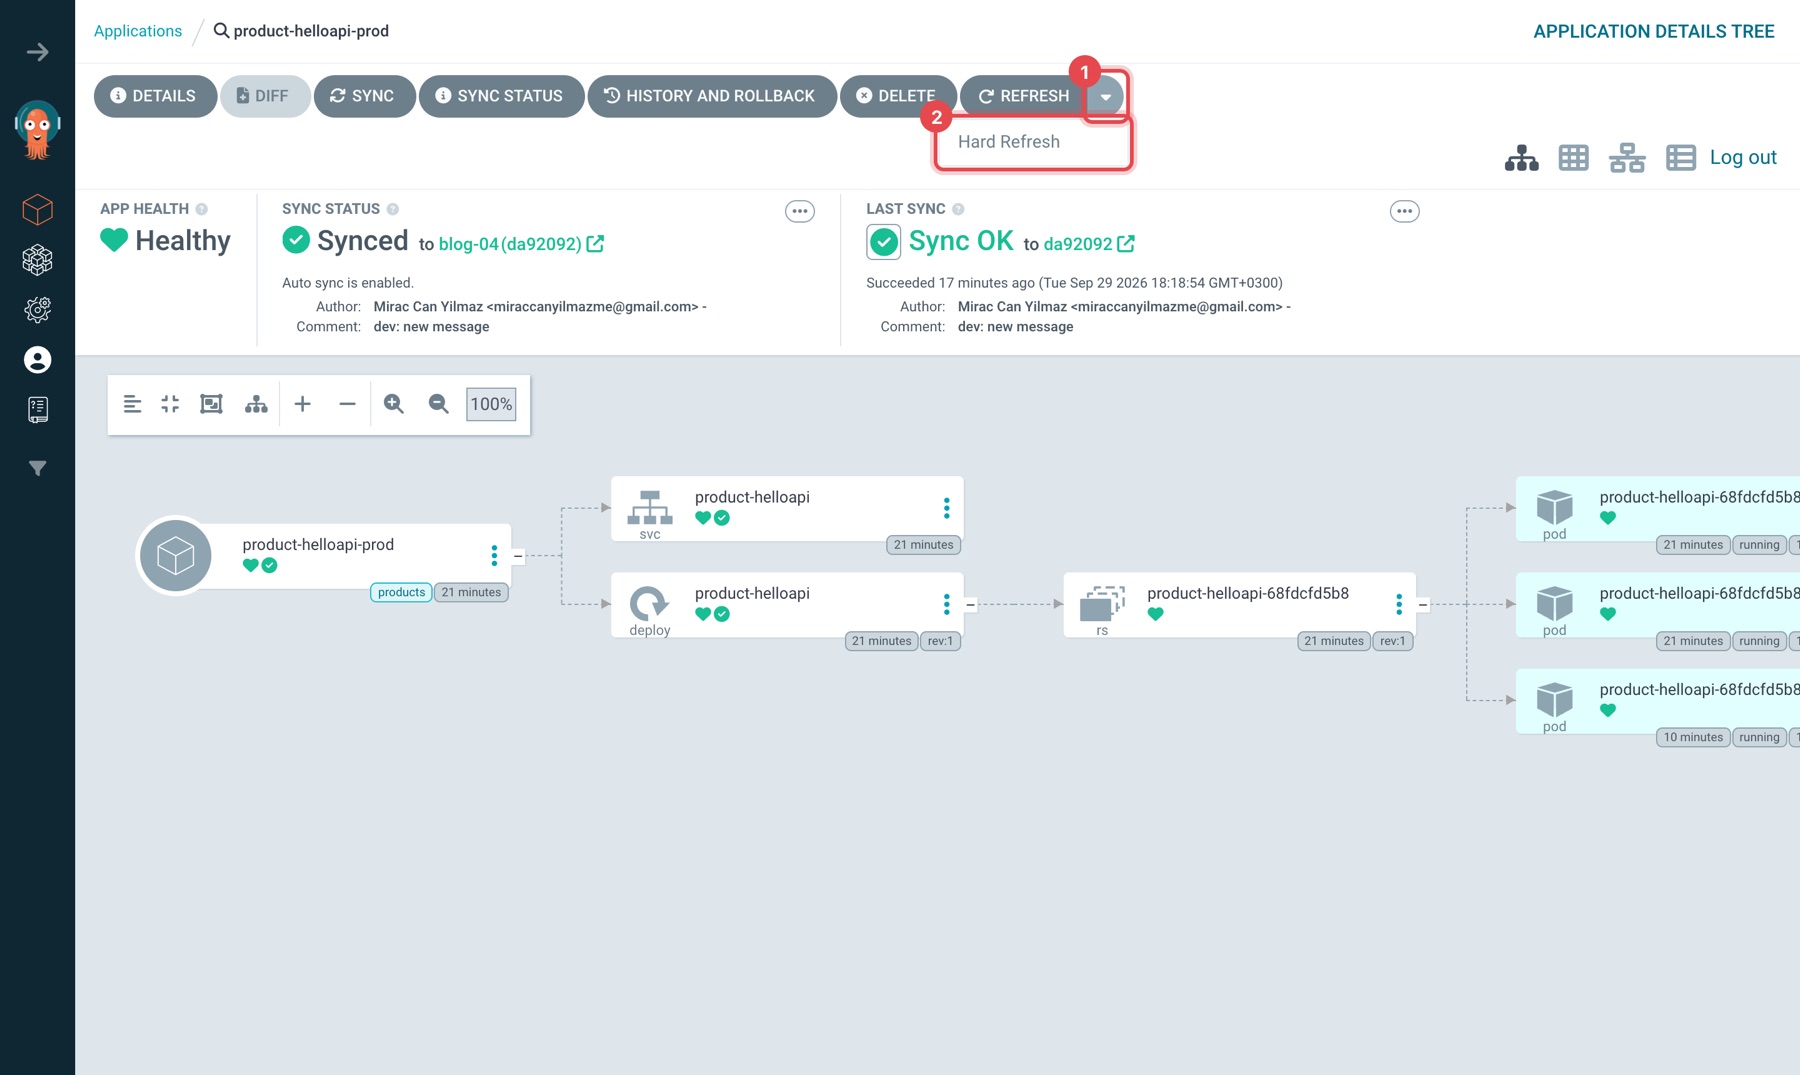
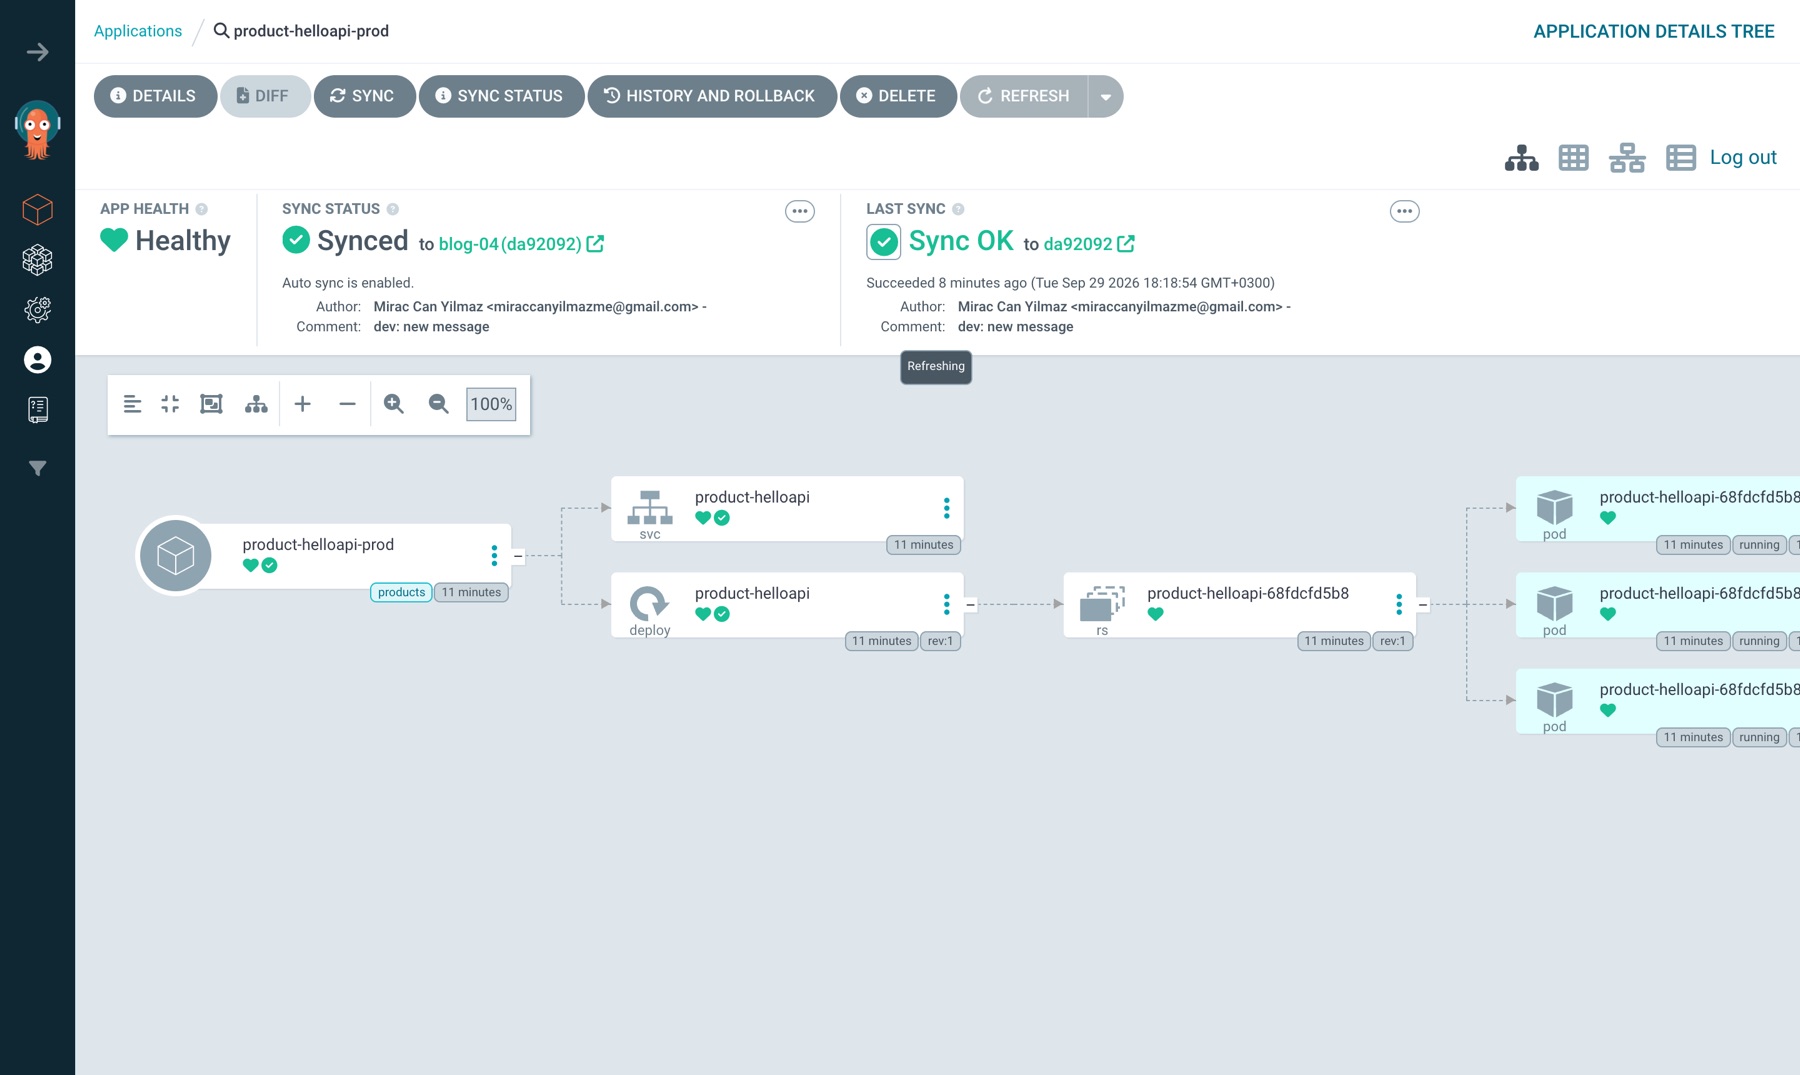
Aynı kontrolü UI'dan da yapabilirsiniz: product-helloapi-prod sayfasında REFRESH'in yanındaki ok (1) → Hard Refresh (2). Sağlıklı bir cluster'da REFRESH düğmesi soluklaşıyor, LAST SYNC'in altında Refreshing rozeti çıkıyor ve birkaç saniyede kayboluyor (bu çalıştırmada 4 saniyeden kısa). Rozet kaybolmuyorsa bir şeyler ters gidiyor. LAST SYNC'teki zaman ise değişmiyor: o son sync'in zamanı ve refresh yeni bir sync başlatmıyor, sadece karşılaştırmayı yeniliyor.
make failover'ı ikinci terminalde çalıştırmadan önce tarayıcıda iki sekme açın: birinde argocd Application'ı Pods görünümünde (http://localhost:8080/applications/argocd/argocd?view=pods), diğerinde product-helloapi-prod (http://localhost:8080/applications/argocd/product-helloapi-prod). Arızaları ilk sekmede izleyeceğiz, Hard Refresh'i ikincisinden isteyeceğiz. Script yaklaşık dokuz dakika sürüyor ve her aşamanın başında saat yazıyor; aşağıdaki ekranları o saatlere göre takip edin.
$ make failover
baseline: hard refresh reconciled in 2s

== 1. Redis master
12:34:22 master is argocd-redis-ha-server-1 (sentinel: 10.96.201.134), deleting
right after redis master delete: hard refresh reconciled in 6s
12:34:34 sentinel promoted 10.96.229.162 after 12s

== 2. repo-server
12:34:34 deleting argocd-repo-server-566fc4b49f-hxtxz
right after repo-server delete: hard refresh reconciled in 1s

== 3. node running the application controller
12:34:36 controller on argocd-ha-worker2; on the same node:
   argocd-application-controller-0
   argocd-redis-ha-haproxy-647d9bfdf8-5l94l
   argocd-redis-ha-server-2
   argocd-repo-server-566fc4b49f-jkcw6
12:34:36 docker stop argocd-ha-worker2
with argocd-ha-worker2 down: no reconciliation for 420s (last: 2026-09-28T09:34:34Z)
12:41:37 controller pod:
   argocd-application-controller-0 Terminating argocd-ha-worker2
   node argocd-ha-worker2 NotReady
12:41:37 docker start argocd-ha-worker2
after argocd-ha-worker2 is back: hard refresh reconciled in 31s
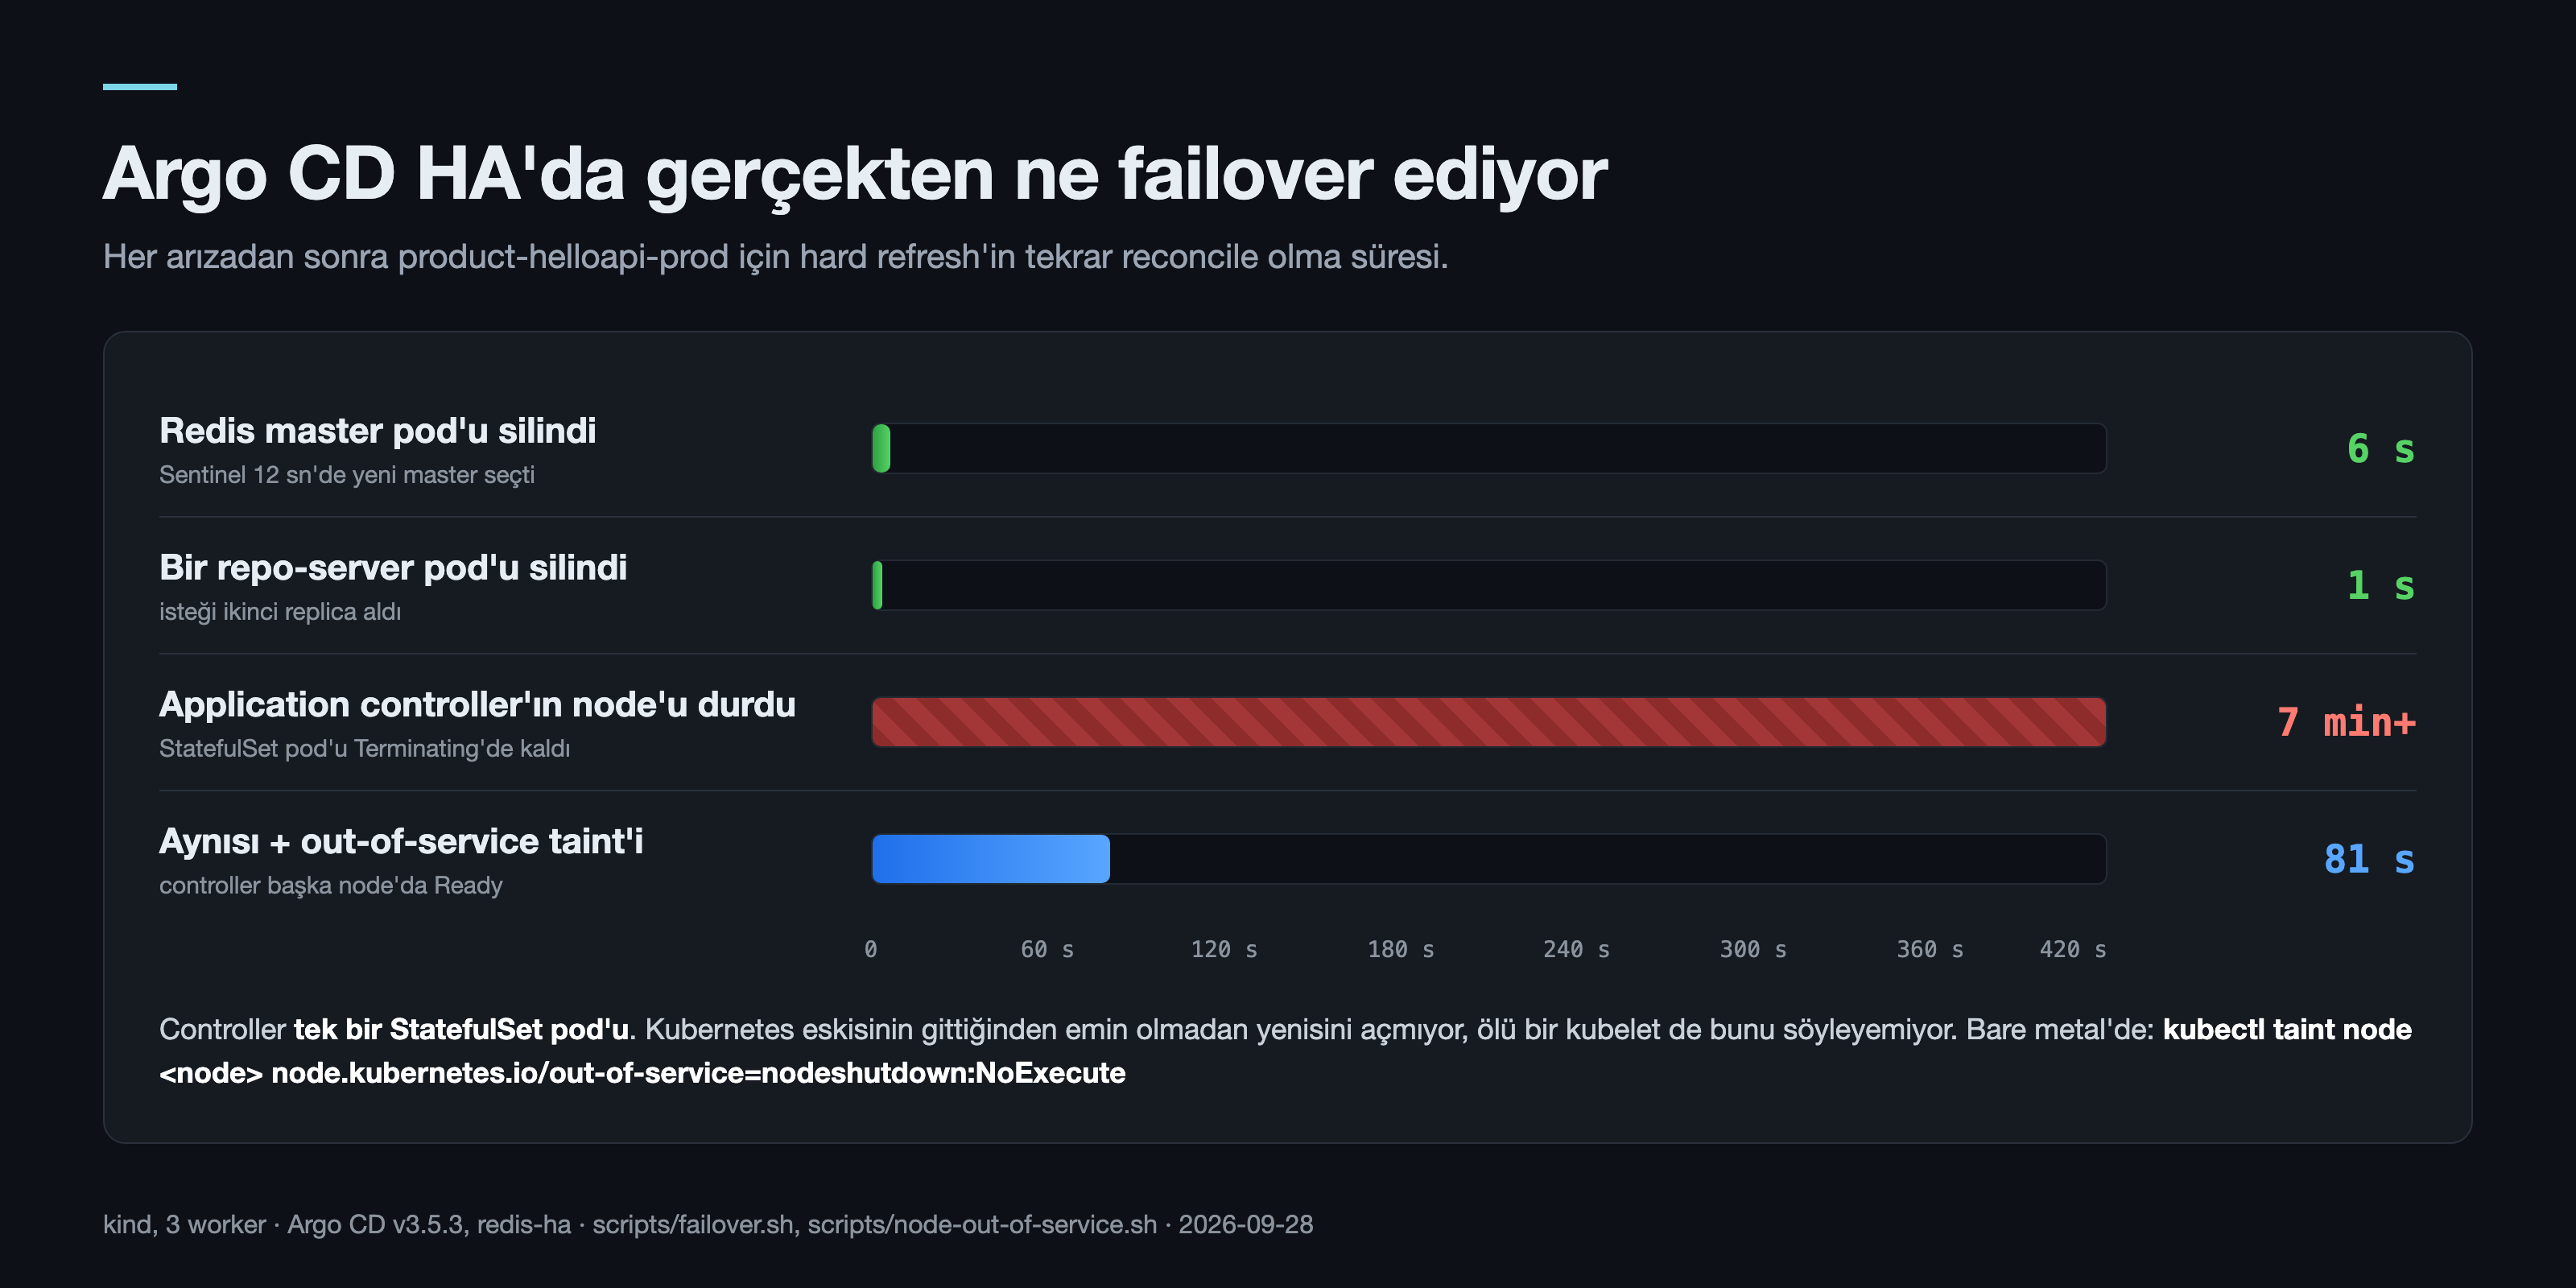
Redis master: Sentinel bir replica'yı 12 saniyede master yaptı (önceki bir denemede 41). O pencere içinde başlatılan refresh bile 6 saniyede bitti. Redis, Argo CD için bir cache; yavaş bir cache kesinti değil. UI'da bu arıza neredeyse görünmüyor: master silindikten bir buçuk saniye sonra worker3'te yeni Redis pod'u mavi (Progressing), Application hâlâ Healthy.
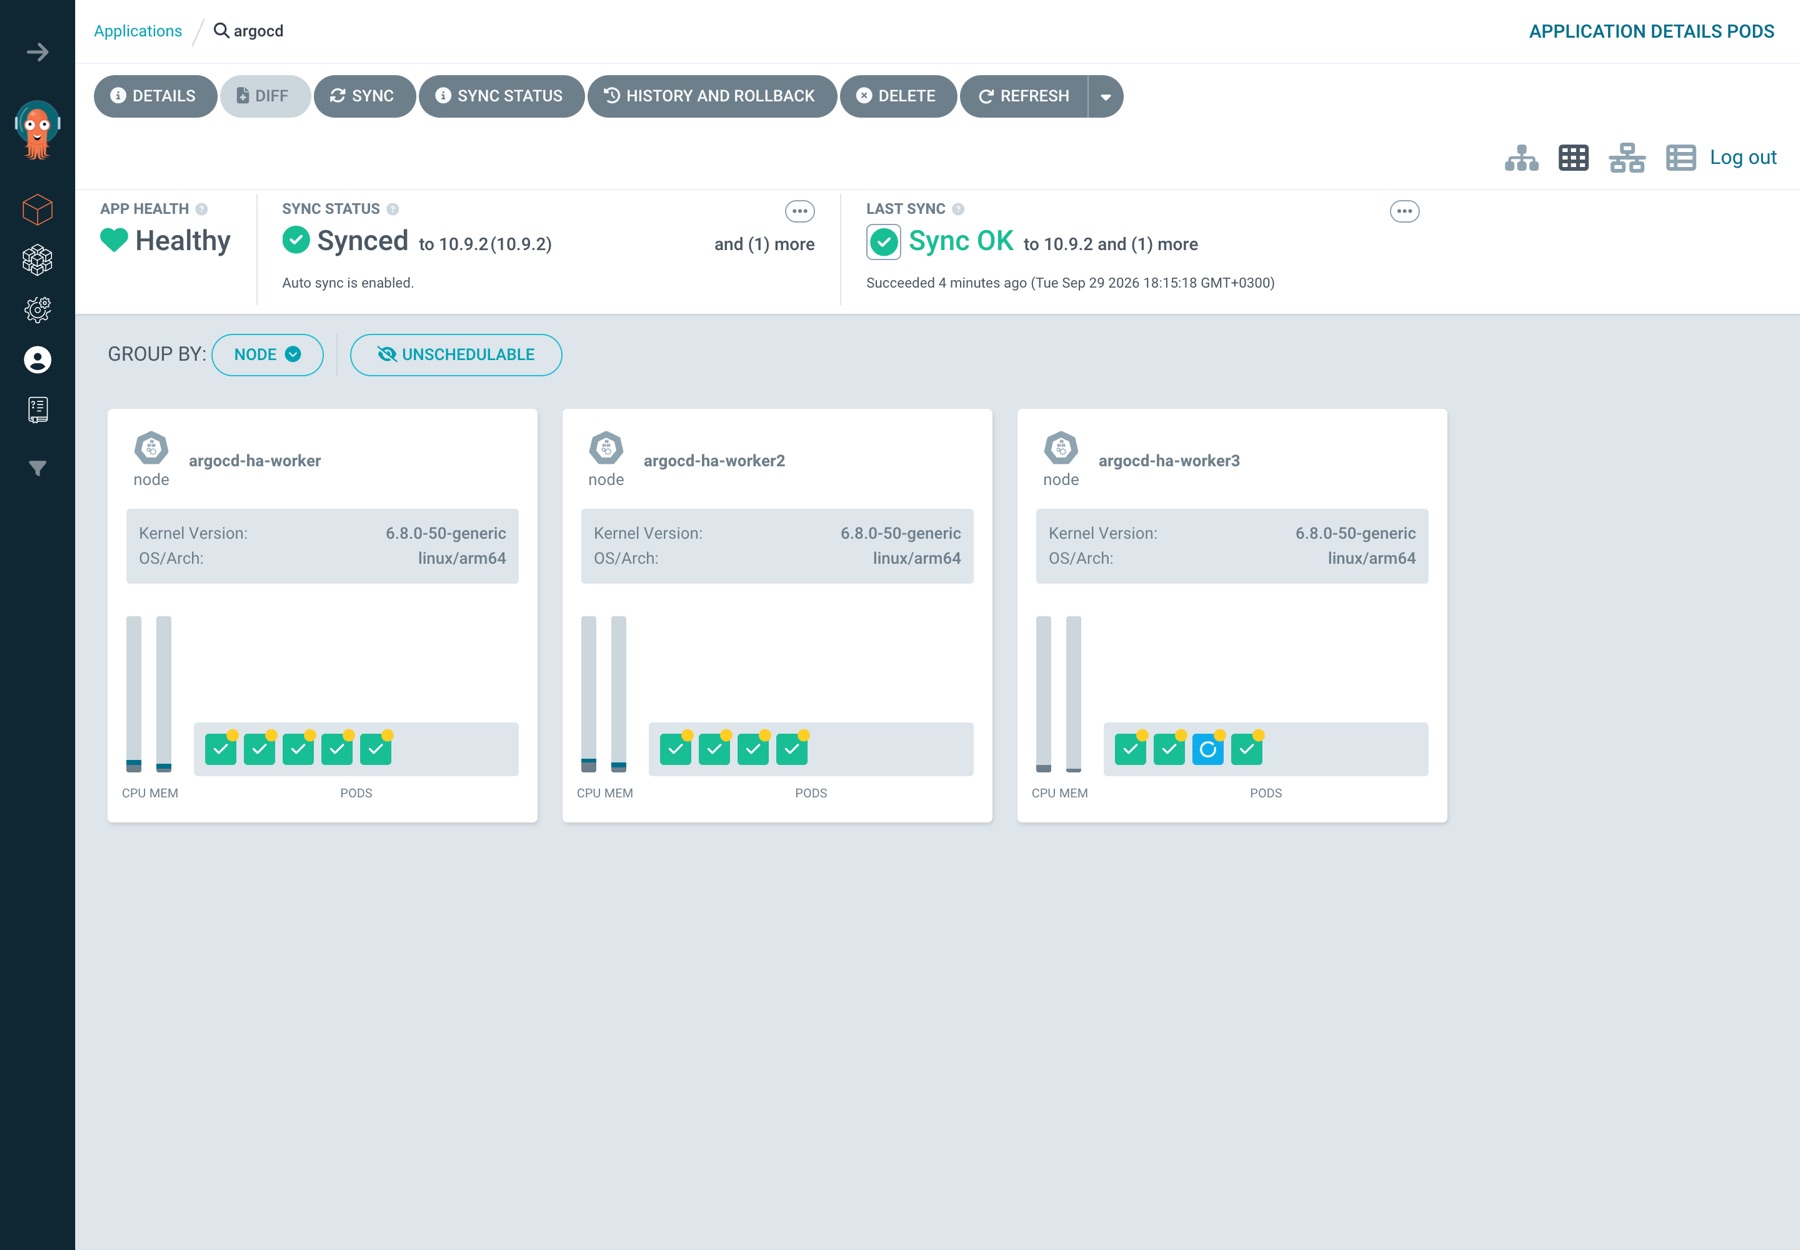
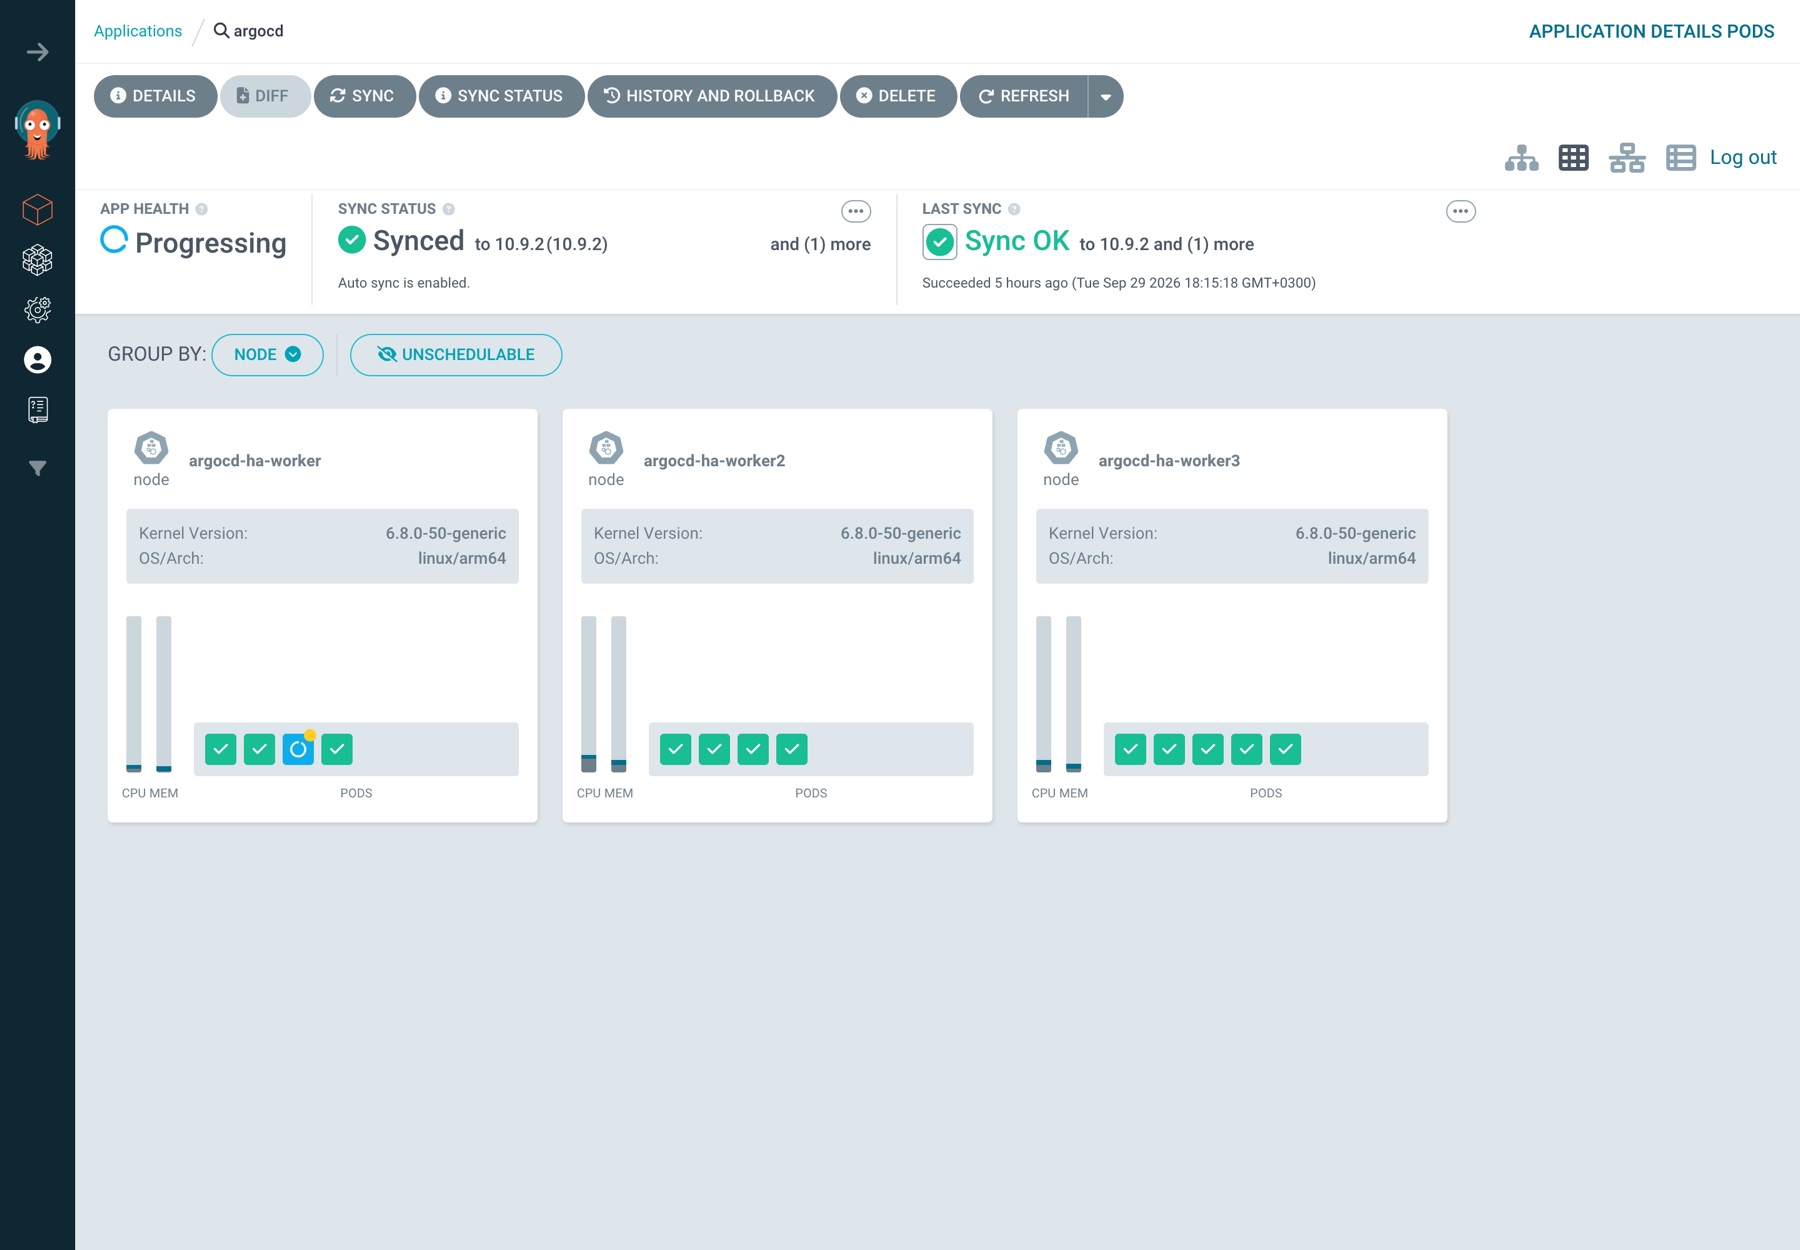
repo-server: 1 saniye. İsteği diğer replica aldı. Pods görünümünde silinen pod kayboluyor, yerine gelen pod birkaç saniye mavi (Progressing) kalıyor; Application'ın health'i o sürede Progressing, sync durumu Synced. İkinci sekmeden Hard Refresh isterseniz Refreshing rozeti birkaç saniyede kayboluyor.
Controller'ın node'u: yedi dakika hiçbir şey. docker stop, Kubernetes'in gözünde ölü bir node'a benziyor: kubelet raporlamayı bırakıyor, node 40–50 saniye içinde NotReady oluyor (aşağıdaki çalıştırmada 49) ve varsayılan 5 dakikalık toleration'dan sonra pod eviction için işaretleniyor. Bir Deployment için yedek pod burada başlar. StatefulSet için başlamaz. argocd-application-controller-0 bir StatefulSet pod'u ve StatefulSet, ilkinin gittiğinden emin olmadan aynı kimlikle ikinci bir pod başlatmıyor. Kubelet ölüyken bunu kimse doğrulayamıyor, o yüzden pod node kapalı kaldığı sürece Terminating'de bekliyor. API server, iki repo-server ve üç Redis pod'undan ikisi bu süre boyunca sağlıklıydı. Argo CD sadece hiçbir şeyi reconcile etmiyordu.
UI'da bu arıza yanıltıcı. Node bir dakikadır ölü ve NotReady, ama Pods görünümü argocd-ha-worker üzerinde hâlâ beş yeşil pod gösteriyor:
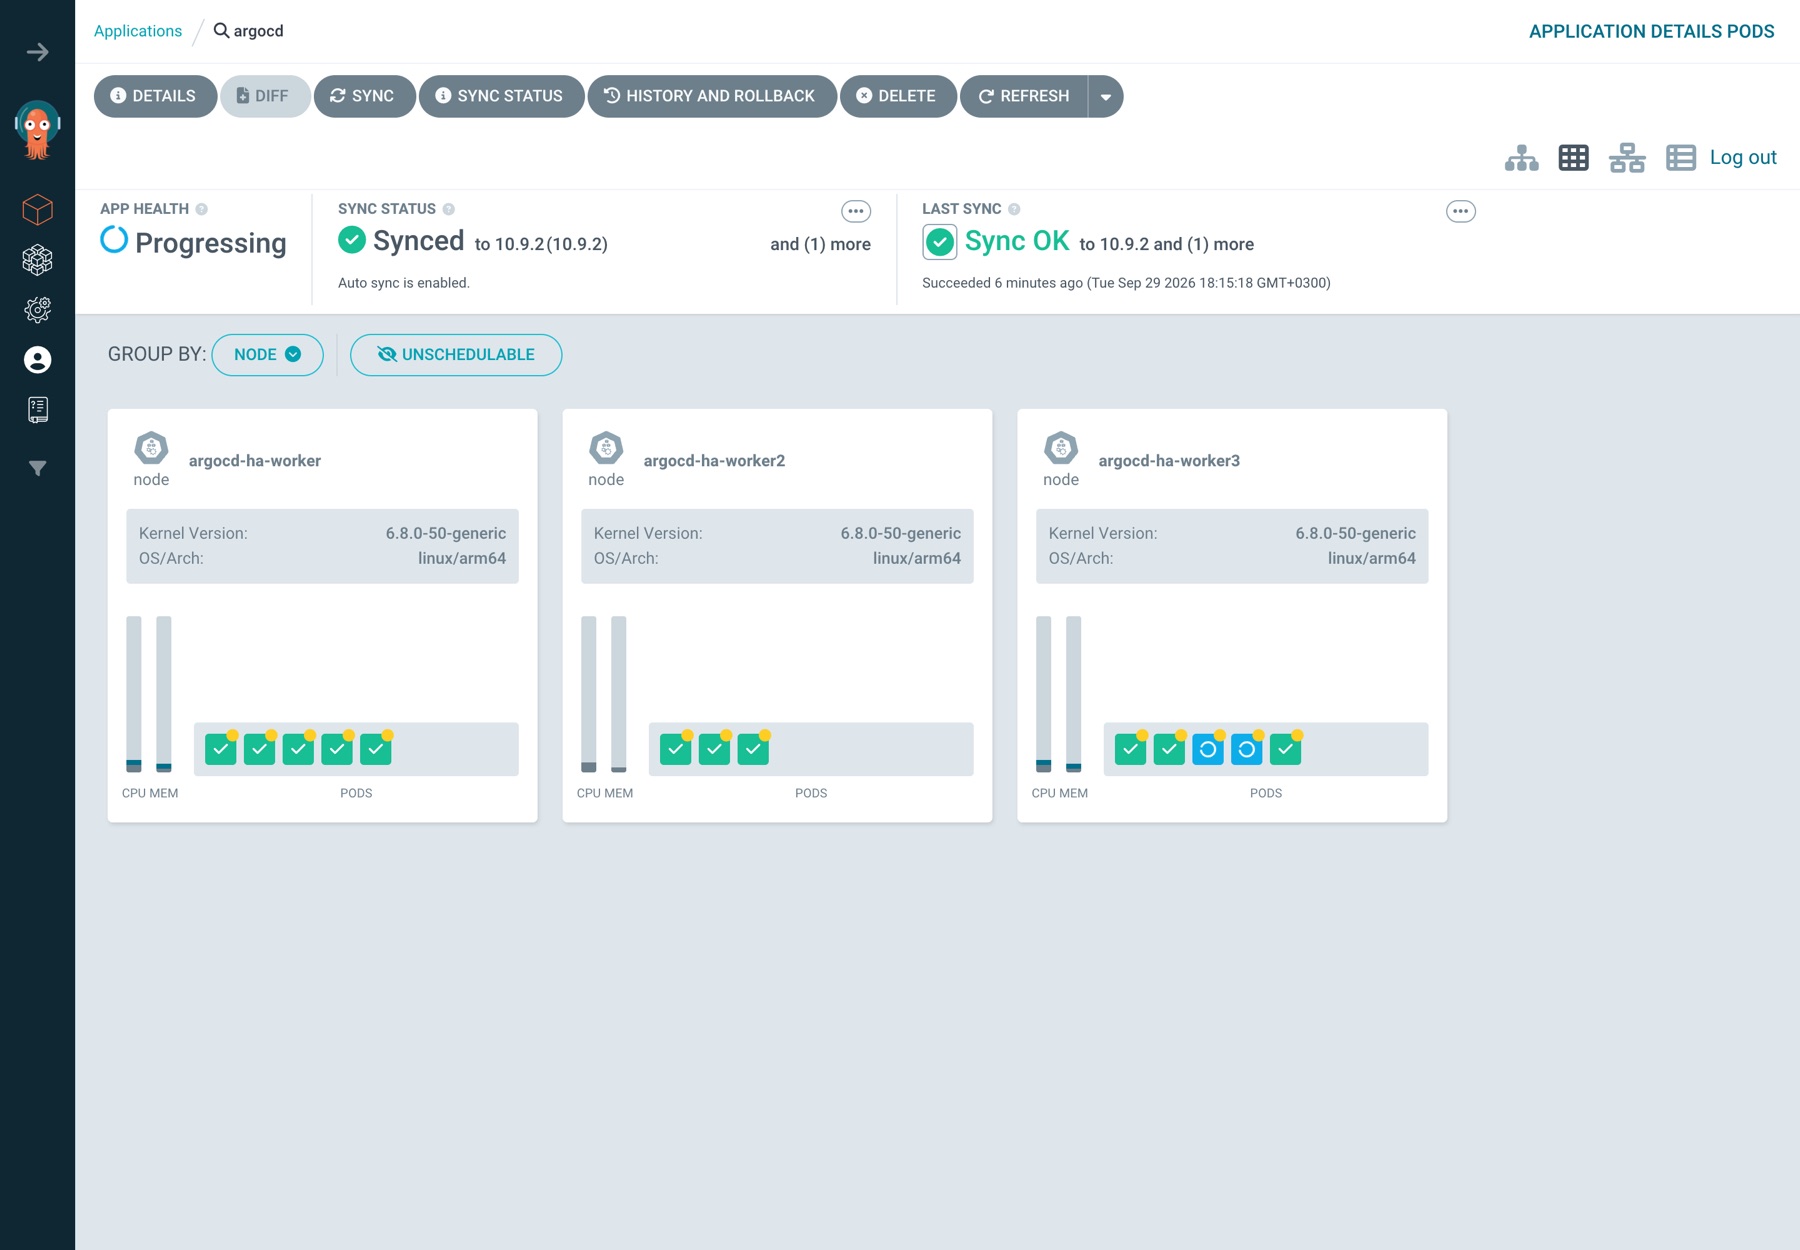
UI'ın gösterdiği canlı durum değil, controller'ın en son yazdığı durum; onu güncelleyecek controller da ölü node'daki beş pod'dan biri. Altıncı dakikada ikinci sekmeye, product-helloapi-prod'a geçin ve Hard Refresh isteyin: Refreshing rozeti gitmiyor, ama Application'ın kartları yine yeşil:
Gerçeği kubectl söylüyor:
$ kubectl -n argocd get pods -o wide --field-selector spec.nodeName=argocd-ha-worker
NAME                                               READY   STATUS        NODE
argocd-application-controller-0                    1/1     Terminating   argocd-ha-worker
argocd-applicationset-controller-d864b8898-74w59   1/1     Terminating   argocd-ha-worker
argocd-redis-ha-haproxy-647d9bfdf8-8rsrb           1/1     Terminating   argocd-ha-worker
argocd-redis-ha-server-2                           3/3     Terminating   argocd-ha-worker
argocd-repo-server-566fc4b49f-dh66r                1/1     Terminating   argocd-ha-worker
Buradan çıkan izleme kuralı: Argo CD'nin sağlığını Argo CD'nin UI'ından okumayın. Application'ların reconciledAt zamanını ya da controller'ın metriklerini dışarıdan izleyin.
Bir cloud provider'da node controller, kapatılan VM'in Node objesini siliyor ve pod yoluna devam ediyor. Bare metal'de bunu kimse yapmıyor. Kubernetes'in bunun için verdiği araç out-of-service taint'i (non-graceful node shutdown, 1.28'den beri GA): node'un gerçekten gittiğini siz beyan ediyorsunuz, Kubernetes de pod'larını zorla siliyor.
$ make out-of-service
12:42:31 docker stop argocd-ha-worker2
12:43:20 argocd-ha-worker2 NotReady after 49s
12:43:20 out-of-service taint added
12:43:52 controller Ready on argocd-ha-worker, 81s after the node died
controller moved: hard refresh reconciled in 3s
12:43:57 argocd-ha-worker2 back, taint removed
UI'da taint'in etkisi Pods görünümünde görünüyor: controller artık argocd-ha-worker3'te, geri dönen argocd-ha-worker'da ise zorla silinip yeniden oluşturulan Redis ve HAProxy pod'ları Progressing.
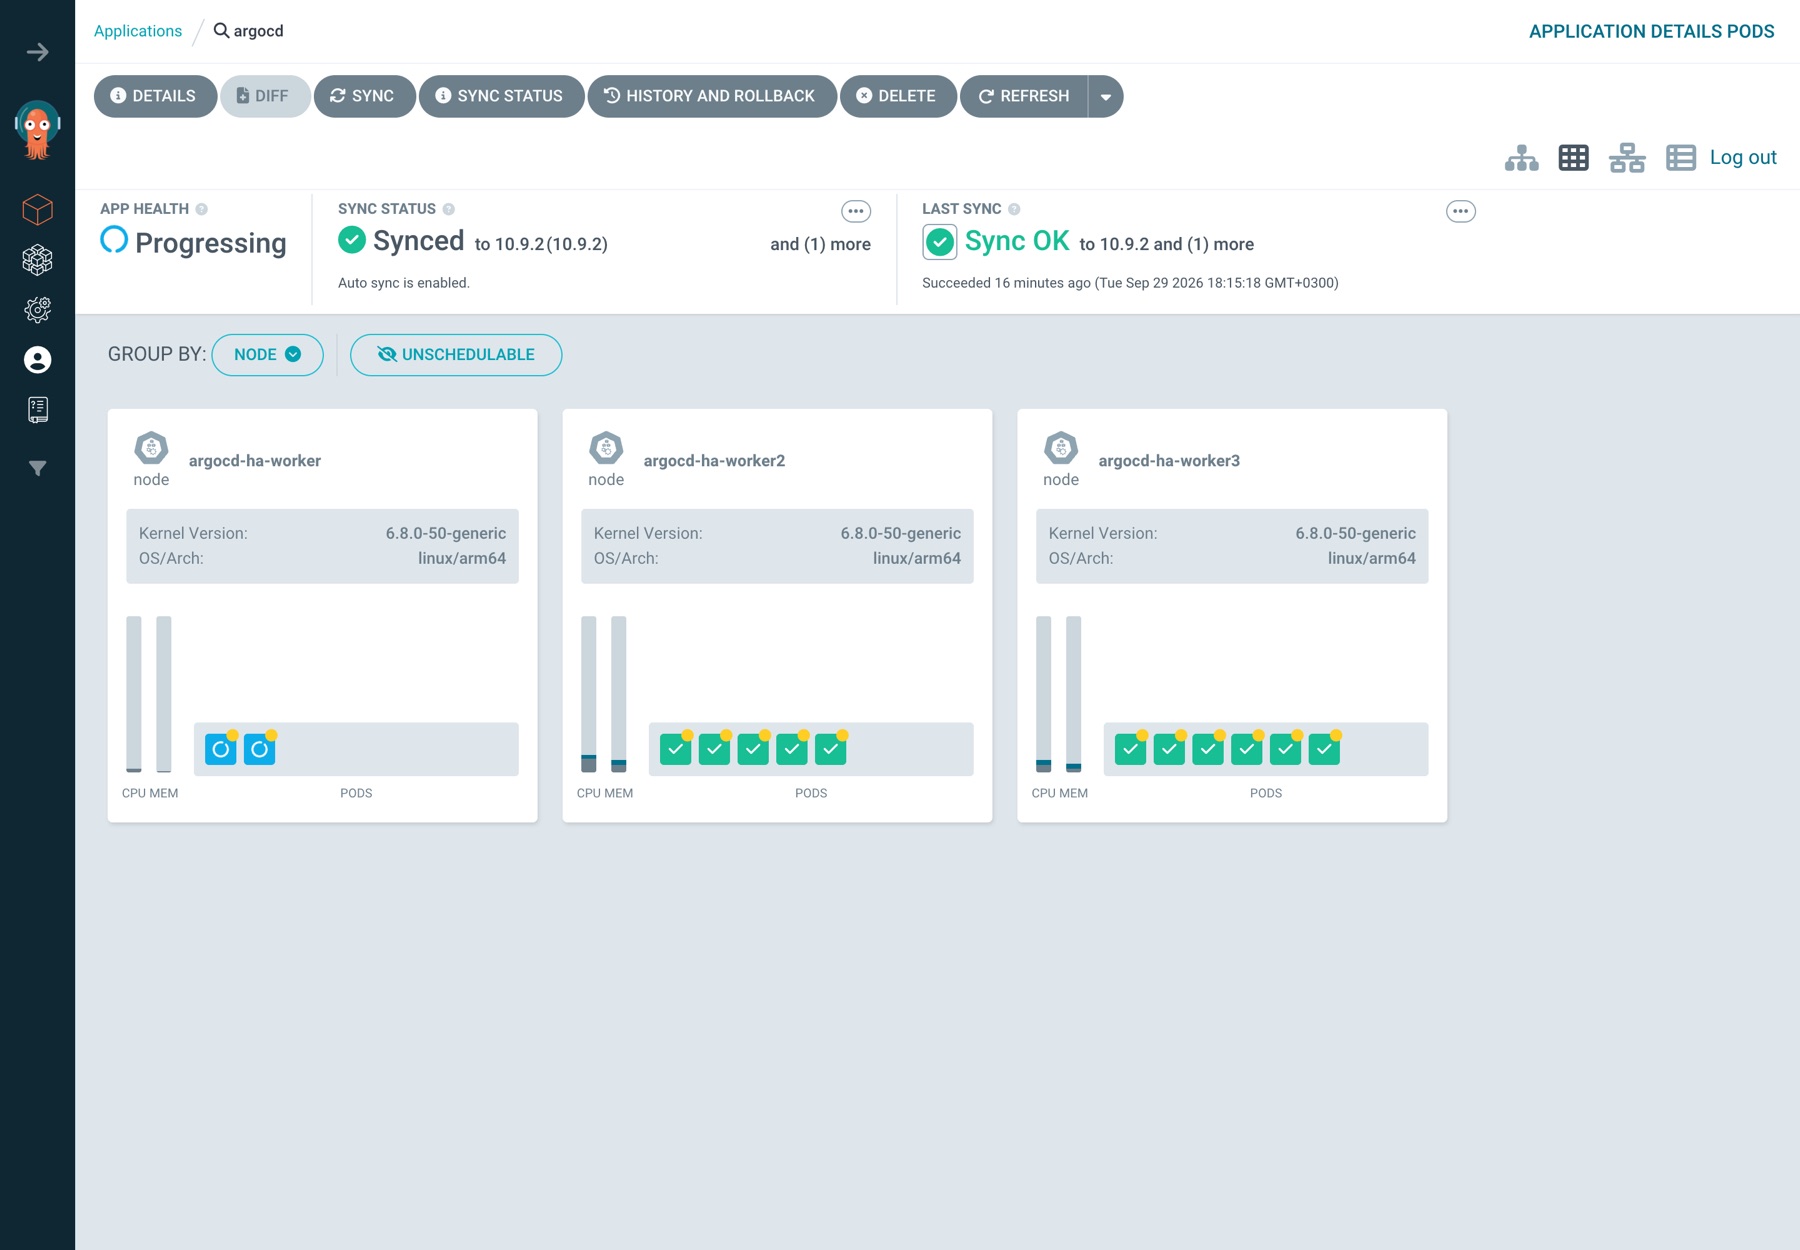
"Biri fark ettiğinde" yerine 81 saniye. Taint'in bir insan kararı olması bilinçli: node sadece ağdan kopmuş ama hâlâ çalışıyorsa, iki controller aynı cluster'a yazar. Komutuyla birlikte "node öldü" runbook'una koyun ve node geri geldiğinde taint'i kaldırın.
Ne ters gitti
1. Label'ı olmayan bir ConfigMap Argo CD'yi düşürüyor. Argo CD kendi ayarlarını sadece isimle değil label ile buluyor. Önceki bir işte, upstream manifest'lerin üstüne uygulanan düz bir argocd-cm patch'i büyük harflerle yazılmış bir uyarıyla başlıyordu: part-of label'ını koru, yoksa her bileşen CrashLoop'a girer. Burada o tek label'ı silerek tekrar ürettim:
$ kubectl -n argocd label cm argocd-cm app.kubernetes.io/part-of-
time="2026-09-28T09:44:50Z" level=fatal msg="configmap \"argocd-cm\" not found"
argocd-server-8646bcb568-2rtwd   0/1   CrashLoopBackOff   3 (12s ago)   51s
argocd-server-8646bcb568-bfdt7   0/1   CrashLoopBackOff   3 (12s ago)   51s
ConfigMap orada duruyor; mesaj "not found" diyor çünkü arama app.kubernetes.io/part-of: argocd ile filtreliyor. selfHeal label'ı 40 saniye içinde geri koymadı, ben elle koydum. (O anda Redis bir önceki testten hâlâ toparlanıyordu, bkz. #3; o yüzden 40 saniyeye fazla anlam yüklemem. Çöküşün kendisi anında.) Buradan iki kural çıktı: ayarlar chart'ın configs.cm / configs.params değerlerinden geçer, asla ayrı bir ConfigMap'ten değil; kendini yöneten argocd Application'ı da prune: false kalır. Aynı production notlarında Argo CD'ye kendini yönettirmenin diğer sebebi de vardı: bir kez make ile uygulanmış config aylarca kaymıştı. OIDC issuer yanlış realm'i gösteriyordu, bir secret manifest'i hiç uygulanmamıştı ve UI route'u 404 dönüyordu. Kimse fark etmedi, çünkü Git ile cluster'ı karşılaştıran hiçbir şey yoktu.
Kendi lab'ınızda denerseniz ne göreceğiniz, pod'ların o sırada yeniden başlayıp başlamadığına bağlı. İkinci çalıştırmada label'ı sildim: iki argocd-server pod'u 90 saniye boyunca Running kaldı ve UI çalışmaya devam etti, çünkü server bu ConfigMap'i açılışta okuyor. kubectl -n argocd rollout restart deploy/argocd-server ile yeni bir pod başlatınca o pod aynı configmap "argocd-cm" not found hatasıyla hemen CrashLoop'a girdi. RollingUpdate eski iki pod'u yeni pod hazır olmadan silmediği için UI yine ayaktaydı. Yani bu hata o an sessiz kalıyor, bir sonraki restart'ta, node drain'de ya da Argo CD yükseltmesinde patlıyor. Label'ı geri koyup server'ı yeniden başlatınca yedi Application'ın üçü Unknown'daydı; controller hepsini yaklaşık iki dakikada tekrar yeşile çevirdi:
kubectl -n argocd label cm argocd-cm app.kubernetes.io/part-of=argocd
kubectl -n argocd rollout restart deploy/argocd-server   # CrashLoop'taki pod'u beklememek için
2. selfHeal geri çekiliyor (backoff) ve ilk ölçümümü yanılttı. İlk failover script'im prod Deployment'ını elle 9'a çıkarıp selfHeal'in onu geri almasını ölçüyordu. İlk geri alma 1 saniye sürdü, sonrakiler 6, 54 ve 154 saniye. Bu arızalar değildi, backoff'tu. Controller logu bunu söylüyor:
Skipping auto-sync: already attempted sync to [da92092b10bb...] with timeout 0s (retrying in 4m56.613839256s)
Aynı commit üzerinde tekrarlanan self-heal'ler 2 saniye bekliyor, sonra her seferinde ×3, en fazla 300 saniye (--self-heal-backoff-timeout-seconds, -factor, -cap-seconds). İyi bir varsayılan: Argo CD'nin bir HPA ya da bir operator ile sonsuza kadar kavga etmesini engelliyor. Ama "selfHeal drift'i saniyeler içinde geri alır" cümlesi sadece ilk seferde doğru. Failover kontrollerini backoff'u olmayan hard refresh'e çevirdim.
3. Out-of-service testinden sonra Redis kendiliğinden geri gelmedi. Taint, argocd-redis-ha-server-2'yi de zorla sildi ve pod başka bir yere taşınamadı (zorunlu anti-affinity, diğer iki worker'da zaten birer Redis pod'u vardı). Node geri geldiğinde Sentinel master'ı birkaç kez değiştirdi ve server-1 startup probe'unda role=slave; repl=connect ile takılı kaldı. StatefulSet OrderedReady olduğu için server-1 Ready olmadan server-2'yi oluşturmadı. Application'lar Unknown'a düştü (UI'da hangilerinin etkilendiğini sol paneldeki SYNC STATUS filtresinden Unknown'ı seçerek görebilirsiniz), controller NOREPLICAS Not enough good replicas to write logladı. argocd-redis-ha-server-1'i silmek çözdü: 63 saniye sonra üç Redis pod'u da 3/3 idi ve yedi Application 14 saniyede tekrar yeşildi. Her seferinde olmuyor: lab'ı sıfırdan kurduğum ikinci çalıştırmada Redis 100 saniye içinde kendiliğinden 3/3'e döndü. Yine de Redis pod'u çalıştıran bir node'a out-of-service taint'i uygularsanız, sonrasında kubectl -n argocd get pods -l app=redis-ha ile kontrol edin.
4. ApplicationSet'teki sync wave süs. products-appset.yaml, ürettiği Application'lara argocd.argoproj.io/sync-wave: "0", namespaces-appset.yaml de "-1" koyuyordu; fikir namespace'lerin önce gelmesiydi. Wave'ler tek bir Application'ın sync'i içindeki kaynakları sıralar. Üretilen Application'ları ApplicationSet controller oluşturuyor, bir üst Application'ın kaynakları olarak sync edilmiyorlar; o yüzden bu annotation'lar hiçbir şeyi sıralamıyor. Bu çalıştırmada namespace Application'ları ürün Application'larından bir saniye önce bitti ve hiçbir şey fail olmadı. Bu zamanlamaydı. Serinin ilerisinde ApplicationSet'lere düzgünce bakıyoruz; şimdilik bu wave'lere güvenmeyin.
Doğrulama
make status        # 7 Application Synced/Healthy; 3 worker'a dağılmış 13 Argo CD pod'u
make hello         # iki ortam da overlay'deki image tag ile cevap veriyor
make probe         # hard refresh birkaç saniyede reconcile oluyor
kubectl -n argocd get pdb    # server, repo-server, applicationset: minAvailable 1
kubectl -n argocd get cm argocd-cm -o jsonpath='{.data.timeout\.reconciliation}'   # 120s
UI'da da aynı kontroller:
http://localhost:8080/applications: yedi kart, hepsi Healthy ve Synced; sol paneldeki SYNC STATUS filtresinde Synced 7, Unknown ve OutOfSync 0.argocd→ Pods görünümü: üç worker kartı, toplam on üç yeşil pod, mavi ya da kırmızı yok.product-helloapi-prod→ REFRESH oku → Hard Refresh: sayfanın üstündeki Refreshing rozeti birkaç saniyede kayboluyor.- ApplicationSets sayfası:
namespacesveproducts, ikisi de Healthy, her biri 2 Application.
Kaynaklar: argo/argo-cd chart README'si ("HA mode", en az 3 worker node), Argo CD dokümanları High Availability ve Cluster Bootstrapping (app of apps), self-heal backoff bayrakları için v3.5.3'te argocd-application-controller --help, Kubernetes dokümanı Non-Graceful Node Shutdown.
HA size ne kazandırıyor, tek tabloda
| Arıza | Ne oldu | Sizin yapacağınız |
|---|---|---|
| Redis master pod'u ölür | Sentinel 12–41 sn'de yeni master seçer; refresh yine 6 sn'de çalıştı | hiçbir şey |
| Bir repo-server ölür | diğeri karşılar; 1 sn | hiçbir şey |
| Bir API server ölür | UI/CLI diğerinden devam | hiçbir şey |
| Controller'ın node'u ölür | node dönene kadar reconciliation yok | out-of-service taint'i → 81 sn'de geri; sonra Redis'i kontrol et |
| Biri argocd-cm'i elle düzenler | bileşenler CrashLoop'a girer | ayarlar sadece chart values üzerinden |
Bu seride
Bu, Production'da GitOps serisinin ilk yazısı. Blogdaki önceki yazı: Cluster API Docker Provider Talos'u Neden Ayağa Kaldıramaz · Sonraki: Argo CD SSO: admin Parolası Yerine İnsanlar için OIDC ve RBAC. Bu lab'da Dex bilerek kapalı; geri döndüğü yer orası.
Bu yazının kodu: https://github.com/miraccan00/blog-wiki/tree/main/argocd-ha-app-of-apps